同一个大模型,为什么换个地方用就变笨了?
我最近一直被一件事困扰。以 DeepSeek V4 Pro 为例,同一个模型,我用不同的方式调用它,出来的质量完全不一样。
官网网页版是一种感觉,官方 API 是一种感觉,接到飞书机器人里又是另一种。飞书内部还分层:在群聊里 @ 它,回答明显降质;私聊它好一些;在平台后台直接问,又好一些;表现最好的,是不经任何中转、直连官方 API。
我原本以为是自己心理作用,上网搜了一圈,发现这种感觉几乎遍布每一家主流模型。我把小红书、B 站、抖音、YouTube 上的相关讨论翻了一遍,相关视频看了十几条,DeepSeek、GPT、Claude、Gemini、千问都查了一遍。结论是:这事是真的,而且每一家都有自己的版本。
各家网友的真实体验
先说 DeepSeek,毕竟我自己是从它开始注意到的。
B 站有条 33 万播放的视频叫「deepseek网页版和API版差距巨大!」。这条视频我完整看了,UP 主的实测方法是问一个具体问题:活化石的现存物种实际是多少年前的物种、出自哪个分支。官网专家模式的回答答非所问,用他的原话说,是「彻底沉浸在活化石这个关键词里了」。同一个问题丢给 Chatbox 里连的 API 版,最后直接给出一张表格,现存物种、分支、年代一目了然,而且模型会反复确认问题到底在问什么。他的结论很直接:网页版和 API 根本不是一个东西。
更关键的是另一条中字视频扒出来的细节:DeepSeek 官方 API 文档里曾明确写着,deepseek-chat 对应的是 V3.2 模型,「这与应用程序或网页版本不同」。也就是说官方文档自己承认,网页版和 API 版不是同一个东西。网上还流传过据称来自 DeepSeek 员工的截图,说 API 用的是更大的基础模型,网页和应用用的是小模型。截图真假没法确认,但商业逻辑讲得通:给几百万聊天用户跑旗舰模型太贵,网页用户要的是快,开发者走 API 要的是原始能力。
小红书上也有一批 V4 Pro 的用户体验帖,「感觉deepseek v4pro降智了」这条的作者是搭配 Claude Code 用的,抱怨它前言不搭后语,「没做的说成做了」。这类帖子从 6 月一直发到 8 月。
GPT 这边的情况比较有意思,方向是反的。
小红书有条 101 赞的帖子说,做代码 Review 最强的其实是 ChatGPT 网页版上的 GPT-5.6 Sol Pro 模式,水平让 Fable 5 都甘拜下风。但网页端问多了会被自动切到 GPT 5.5 mini,而且只有手机版能稳定用 Pro。也就是说网页版不是不能用满血,是会被悄悄降档,而且降档的时候不会告诉你。
B 站有两条讲 GPT 降智排查的视频,我都看了。结论是不少账号的「降智」其实和网络环境有关:IP 频繁变动、节点在不同国家之间横跳、同一个节点挂了一堆账号,都可能让账号被标记,然后被路由到轻量模型。有视频给了判断方法:丢给它一个有难度的任务,看它会不会主动搜索、思考链路完不完整,要是秒回而且内容又短又浅,追问一句「你现在是什么模型」,它甚至可能承认自己是某个轻量版。换个稳定的网络静置一段时间,通常会慢慢恢复。
Claude 是我这次调研里看到最戏剧化的案例。
小红书有条 1099 赞的帖子,标题是「Claude在app端和api真是完全不一样」。作者说同样的 prompt,app 端的 Claude 更多是自我审视、纠结、内耗,「层层过滤后只剩下一个无害的 Claude」;而 API 那边的 Claude 是「一个心智健全、五感俱在的 AI」。她怀疑 Anthropic 给 app 端套了很多层锁。这条帖子 676 收藏,评论 159 条,显然戳中了很多人。
另一条 250 赞的帖子更有意思,作者是个「酒馆 Claude 玩家」,把 Claude 的各种使用渠道按质量排了个序:官方 API 最纯,官方网页 cookie 次之,然后是 OpenRouter 这类正规代理,最后是电商平台上卖的「官转 API」。她的总结是,官转基本没有不渗水的,「可以说体验好但肯定跟纯血不一样」。
Claude 还有一个绕不开的案例,就是今年 4 月那场持续约 47 天的 Claude Code 集体降智。Anthropic 官方复盘确认:底层模型没变,API 正常,问题是三个产品层小改动叠加出来的。有期拆解视频把整个过程讲得很细,时间线很具体:3 月 4 日把推理强度从 high 降到 medium,内部觉得「只弱一点点」,结果程序员对智商的敏感度远高于对延迟的敏感度,扛了一个多月才回滚;3 月 26 日一个缓存优化写错了,闲置过的会话之后每发一句话都会丢掉之前的思考,有人的月度 token 额度 70 分钟就被这个 bug 烧光;4 月 16 日嫌新模型啰嗦,在系统提示词里加了「最终回复不超过 100 词」,真实场景下编码质量掉了 3%。最后逼着官方排查的,是一位高管贴到 GitHub 上的遥测数据:6852 个会话、23 万多次工具调用,读写比从 6.6 跌到 2.0。
Gemini 的情况最典型,因为它把「残血入口」和「完全体入口」明明白白摆在了一起。
小红书有条 357 赞的帖子叫「Gemini很笨?试试在AI Studio里用」。作者说网页端的 Gemini 被大家叫「美国豆包」,笨、胡言乱语、干不了活。但同一个 Gemini 3.1 Pro,放到 Google AI Studio 里就明显更详细、更愿意推理,复杂任务尤其明显。原因据他说是 3 月份网上传出的:谷歌限制了网页端 Gemini 的模型努力程度,固定在 0.5。而 AI Studio 里可以随意调思考深度、temperature、工具调用。他的原话是「在 AI Studio 里,Gemini 才是完全体」。
这条帖子底下 117 条评论,加上另外两条「gemini最近是被降智了吗」(227 赞)、「是的,我已急哭。不会再续费Gemini了」(362 赞),能看出来 Gemini 用户对降智的感受是相当普遍的。
千问这边也有。小红书有条帖子吐槽阿里云 coding plan 的模型降智厉害,「用得越多越发现它真的很降智」,评论有 80 条,但同一计划里的 Qwen3.5 Plus 就没这个问题。
抖音上有三条视频我完整看了,都是拿同一个模型放进不同工具里做对比实测。
第一条拿千问 3.8 Max 做实验,同一个任务分别放进 Claude Code 和 OpenCode 里跑。结果 Claude Code 跑了两个半小时,OpenCode 只用了 24 分钟。作者把模型比作大脑、Agent 比作身体和工具箱:光有聪明的大脑干不了活,你得有身体、有工具、有做事的方法。他还提了个很尖锐的问题:各家发布大模型测评的时候,用的 Agent 根本不是同一个,这种情况下测评结果公平吗?
第二条拿 MiniMax M3 在五个热门 AI 编程工具里跑同一套测试题,十组结果。差距肉眼可见:有的工具 12 个组件全跑通、9 种状态零 bug,有的工具三个明显 bug 外加「AI 风味明显」。同一个模型,换个工具,产出质量能差出好几倍。
第三条讲 DeepSeek V4 Flash 接入不同 Agent 的体验。视频里有个说法我觉得很准:「真正被测试的从来不只有模型,还有不同的 harness、提示词。」同一个模型权重没变,但它看到的上下文、能使用的工具、执行的节奏和验收方式都可能不同。一个 Agent 会先读规则、列计划、修改、运行测试、再检查结果;另一个可能写完代码就宣布完成。这也是为什么同一个模型会同时给人「强得离谱」和「怎么老是翻车」两种感受。
GLM 的情况又不一样,它的「降智」很多其实是后端 bug。B 站费曼学 AI 有条视频把这事讲得很清楚:智谱 GLM-5 用户看到乱码、整段复读、蹦生僻字,表面上跟降智一模一样,但智谱官方回复说「我们没有降低模型精度」,问题出在推理基础设施被 agent 场景逼到了极限。视频里有个比喻我觉得很准:不是厨师手艺退步了,是厨房的管道在高负荷下漏了。厨师还是那个厨师,但餐厅从正餐变成自助餐,订单翻十倍,原来够用的管道就崩了。
为什么会这样
把上面的案例摆在一起看,规律其实很清楚。影响「同一个模型」表现的变量,我归成四层。
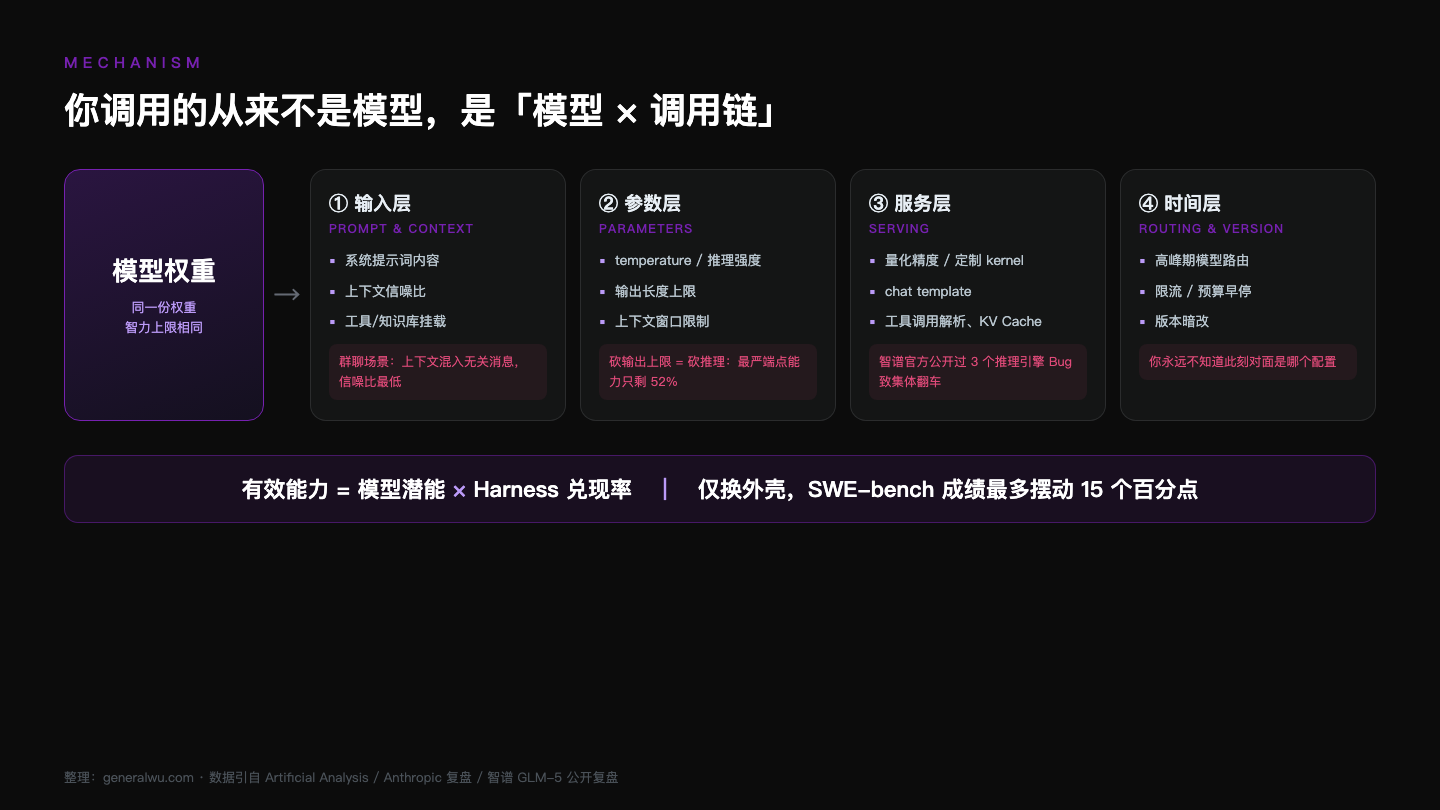
第一层是入口包装。官方产品背后有精心调校的系统提示词、联网搜索、记忆整理;你走 API 拿到的就只有自己写的那几句;而网页版为了扛住海量用户,官方可能直接换小一号的模型,或者锁死思考强度,就像 Gemini 的 0.5。同一个模型名字底下,可能是完全不同的配置。
第二层是参数。思考深度、输出长度上限,这两个对智力的影响比大多数人大得多。B 站有位 UP 主把这事量化了:让模型做需要长思维链的题,没通过的那几轮思考 token 只有 516,通过的那轮有 4660。思考被砍短,答案就是蠢的。输出长度也一样,8 月 4 日评测机构 Artificial Analysis 发布的端点实测里,GLM-5.2 输出限制最狠的端点,科学推理得分不到参考值的一半,推理还没做完就被掐断了。
第三层是中转商的手脚。Artificial Analysis 那份实测测的就是这个:同一个开放权重模型,不同云厂商的 API 端点能保留多少智力。官方权重自托管记为 100 分,gpt-oss-120b 最差的端点工具调用只拿 22 分,参考值是 37 分。服务商为了速度和成本会量化权重、写定制 kernel、调自己的推理栈,官方文章的原话是「有时候干脆带着 bug 就上线了」。小红书上那个 Claude 玩家的结论和这份实测是一个意思:官转基本没有不渗水的。
第四层是时间和状态。高峰期的路由、限流、版本暗改,还有前面说的 IP 标记。你以为你在跟同一个模型说话,实际上对面此刻是什么配置,没人告诉你。有 B 站 UP 主总结过一句挺狠的话:版本不透明,用户永远不知道自己面对的是哪个模型。
这四层说完,回到我自己的飞书梯度就清楚了。群聊里 @ 机器人,上下文混着群聊历史,信噪比最低,平台的场景限制也最保守,四层全踩,所以最差。私聊上下文干净了,但平台的提示词、参数模板、长度截断还在。后台直聊少一层 IM 封装。直连官方 API,参数全在自己手里,没人替你改。每多一层包装,就多一组别人动过的手脚。
要说明白:我这条梯度没有任何论文直接验证过,是体感加上面四层机制推出来的。但每一层机制都有实测或官方材料支撑,方向上我有信心。
我的建议
聊点实际的。
重要的任务,尽量直连官方 API,参数自己掌握。如果只能用网页版或第三方,心里要有数:你拿到的可能不是满血。
系统提示词写具体。你是谁、回答给谁看、什么格式、哪些不能编,别再只丢一句「你是一个助手」。API 版表现不如预期,十有八九是包装没做,不是模型不行。
检查输出长度上限。推理型模型被砍长度等于被砍脑子,端点实测已经证明这一项就能让能力腰斩。
长对话发现它开始忘事、重复你已经纠正过的错,就开新会话。上下文堆积会让模型一点点滑进笨区,这个过程没有报错,也不会提醒你。
怀疑降智的时候,先做对照:同样的问题、同样的上下文、同样的参数,分别丢给两个渠道,再比输出。不然比出来的差异可能全是包装差异。
最后一条,也是我觉得最重要的:觉得某个 AI 变笨了,先换个调用方式复测一遍,再下结论。很多时候不是模型降智了,是你碰巧用了一条被别人动过很多手脚的调用链。