写代码之前,先让 AI 把你问倒:grill-me 完整拆解
Gary Chen 最近有期视频讲了个很火的 skill,叫 grill-me:写代码之前,先让 AI 反过来问你一轮问题,问到你把需求想清楚为止。视频讲得挺好,但没到源码层面,我把整个仓库的每个 skill 文件都读了一遍,这篇把看到的东西写下来:它到底解决什么问题,凭什么能解决,怎么装、怎么用、什么时候用。
先交代背景。这个项目叫 mattpocock/skills,副标题是「Skills For Real Engineers —— 给真正做工程的人的 skill,不是 vibe coding」。写这篇时它在 GitHub 上有 23.3 万颗星、近 2 万个 fork,skills.sh 上的安装量是数百万次。仓库里最出圈的就是 grill-me:AI 在动工之前反过来把你拷问一轮,一题一题问,问到你把每个设计分支都想清楚。
一、先认识一下 Matt Pocock
不认识他的人一句话介绍:TypeScript 领域最有名的老师之一,Total TypeScript 的作者,很多开发者是跟着他的教材学会 TypeScript 的。这一年他把重心搬到了 AI 开发上,这个仓库就是他把自己日常用的 AI 工作流开源了出来,从写规格、拆任务、写测试到 code review,全套都有。
README 开头说明了这套东西为什么存在:GSD、BMAD、Spec-Kit 这类大框架靠「接管整个流程」来帮你,但接管的同时也拿走了控制权,流程里出了 bug 极难修。他走了相反的路:每个 skill 刻意做得很小、很好改、能自由拼装,适配任何模型,内容全部来自几十年软件工程的成熟经验。后面所有设计都建立在这个「小且模块化」的前提上。
二、为什么要用:AI 的四种死法
要理解 grill-me 为什么存在,先看 Matt 在 README 里列的四个常见失败模式,基本是所有人用 AI 写代码都踩过的坑。
第一种:「Agent 没做我想要的」。你以为你说清楚了,看到产出才发现它根本没理解你。《程序员修炼之道》里那句「没有人确切知道自己想要什么」,在 AI 时代照样成立。你和 agent 之间有一道沟通鸿沟,而 grill-me 这类「拷问会话」就是填这道沟的:让 agent 反过来问你细节,在动工之前对齐。
第二种:「Agent 太啰嗦」。它不懂你项目里的行话,20 个词说 1 个词能说清的事。Matt 的解法是共享语言,后面讲 grill-with-docs 时展开。
第三种:「代码跑不起来」。对齐了需求,AI 还是产出垃圾?问题出在反馈环。没有类型检查、没有浏览器、没有自动化测试,AI 就是蒙眼飞行。所以他做了 tdd,强制红灯-绿灯循环。
第四种:「我们造了一团泥」。AI 写代码太快了,快到你来不及关心设计,软件熵以惊人的速度积累。他的解法是把「深模块」这套经典设计经验写进 skill,定期给代码库做大扫除。
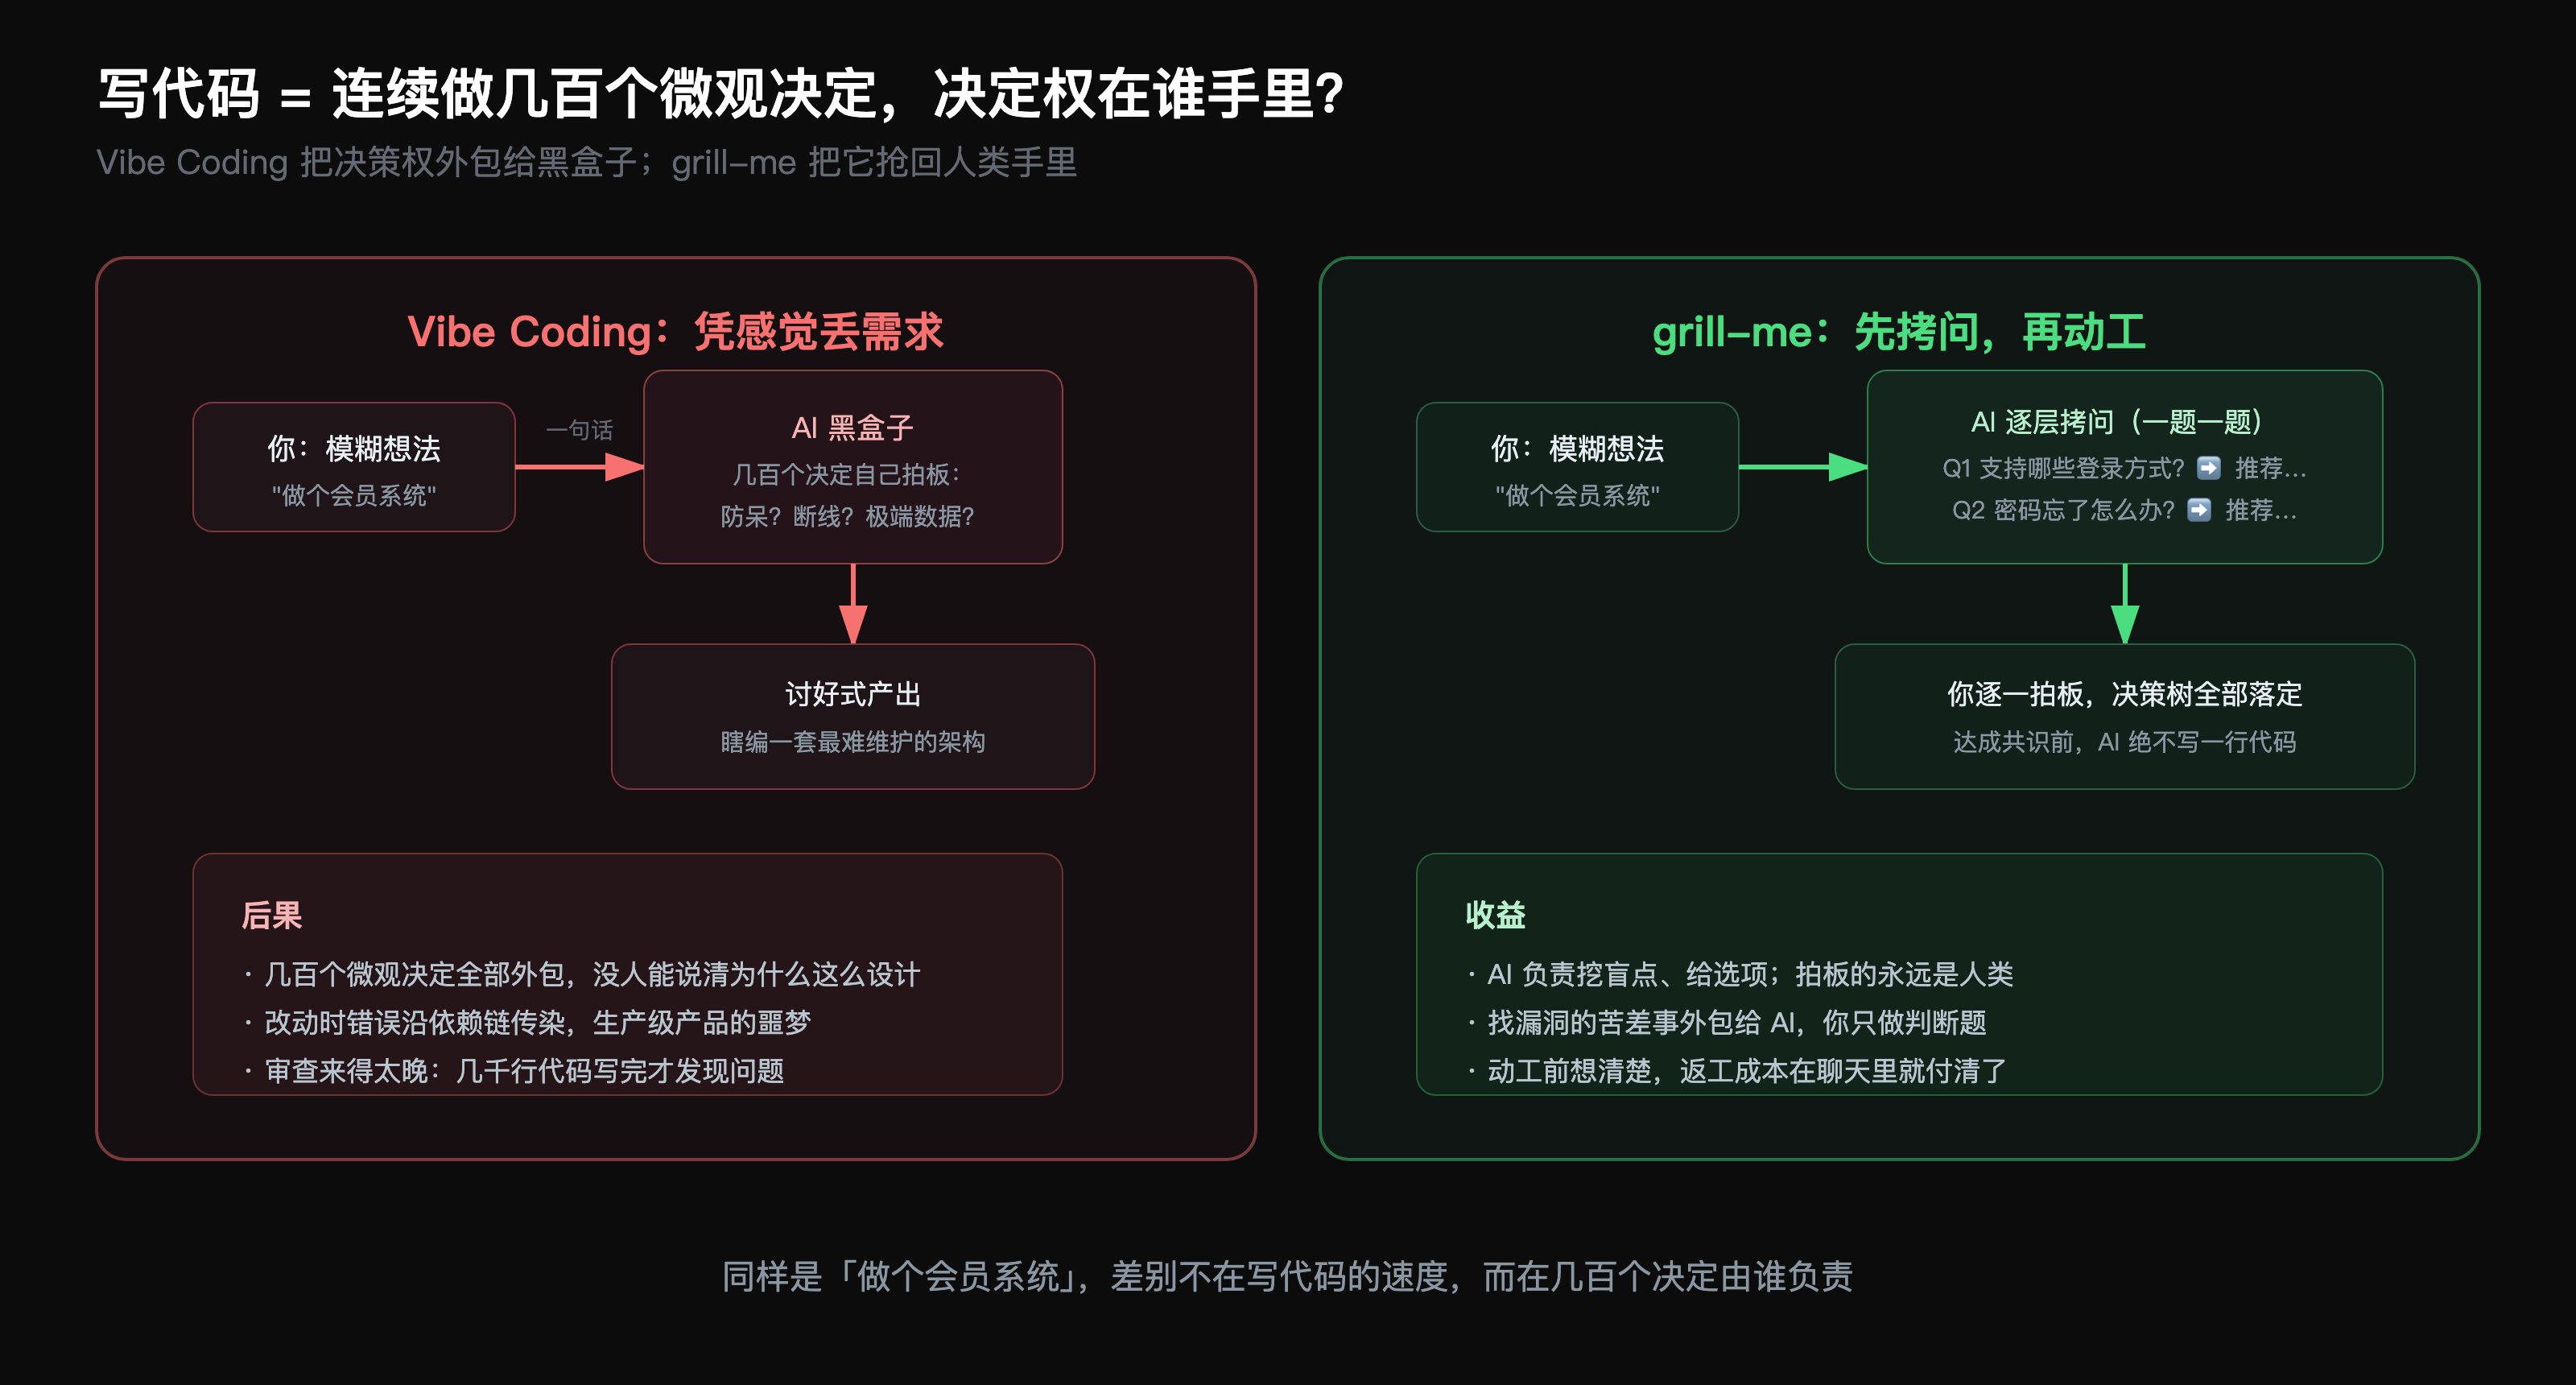
grill-me 针对的就是第一种,也是软件开发里最常见、最贵的一种失败:错位。写代码的本质是连续做几百个微观决定,防呆怎么做、断线怎么办、极端数据怎么处理。把模糊的想法直接丢给 AI 凭感觉做,等于把这几百个决定全部外包给一个黑盒子,而黑盒子为了讨好你,通常会瞎掰出一套最难维护的架构。
三、grill-me 的真身:一行转发 + 28 行拷问手册
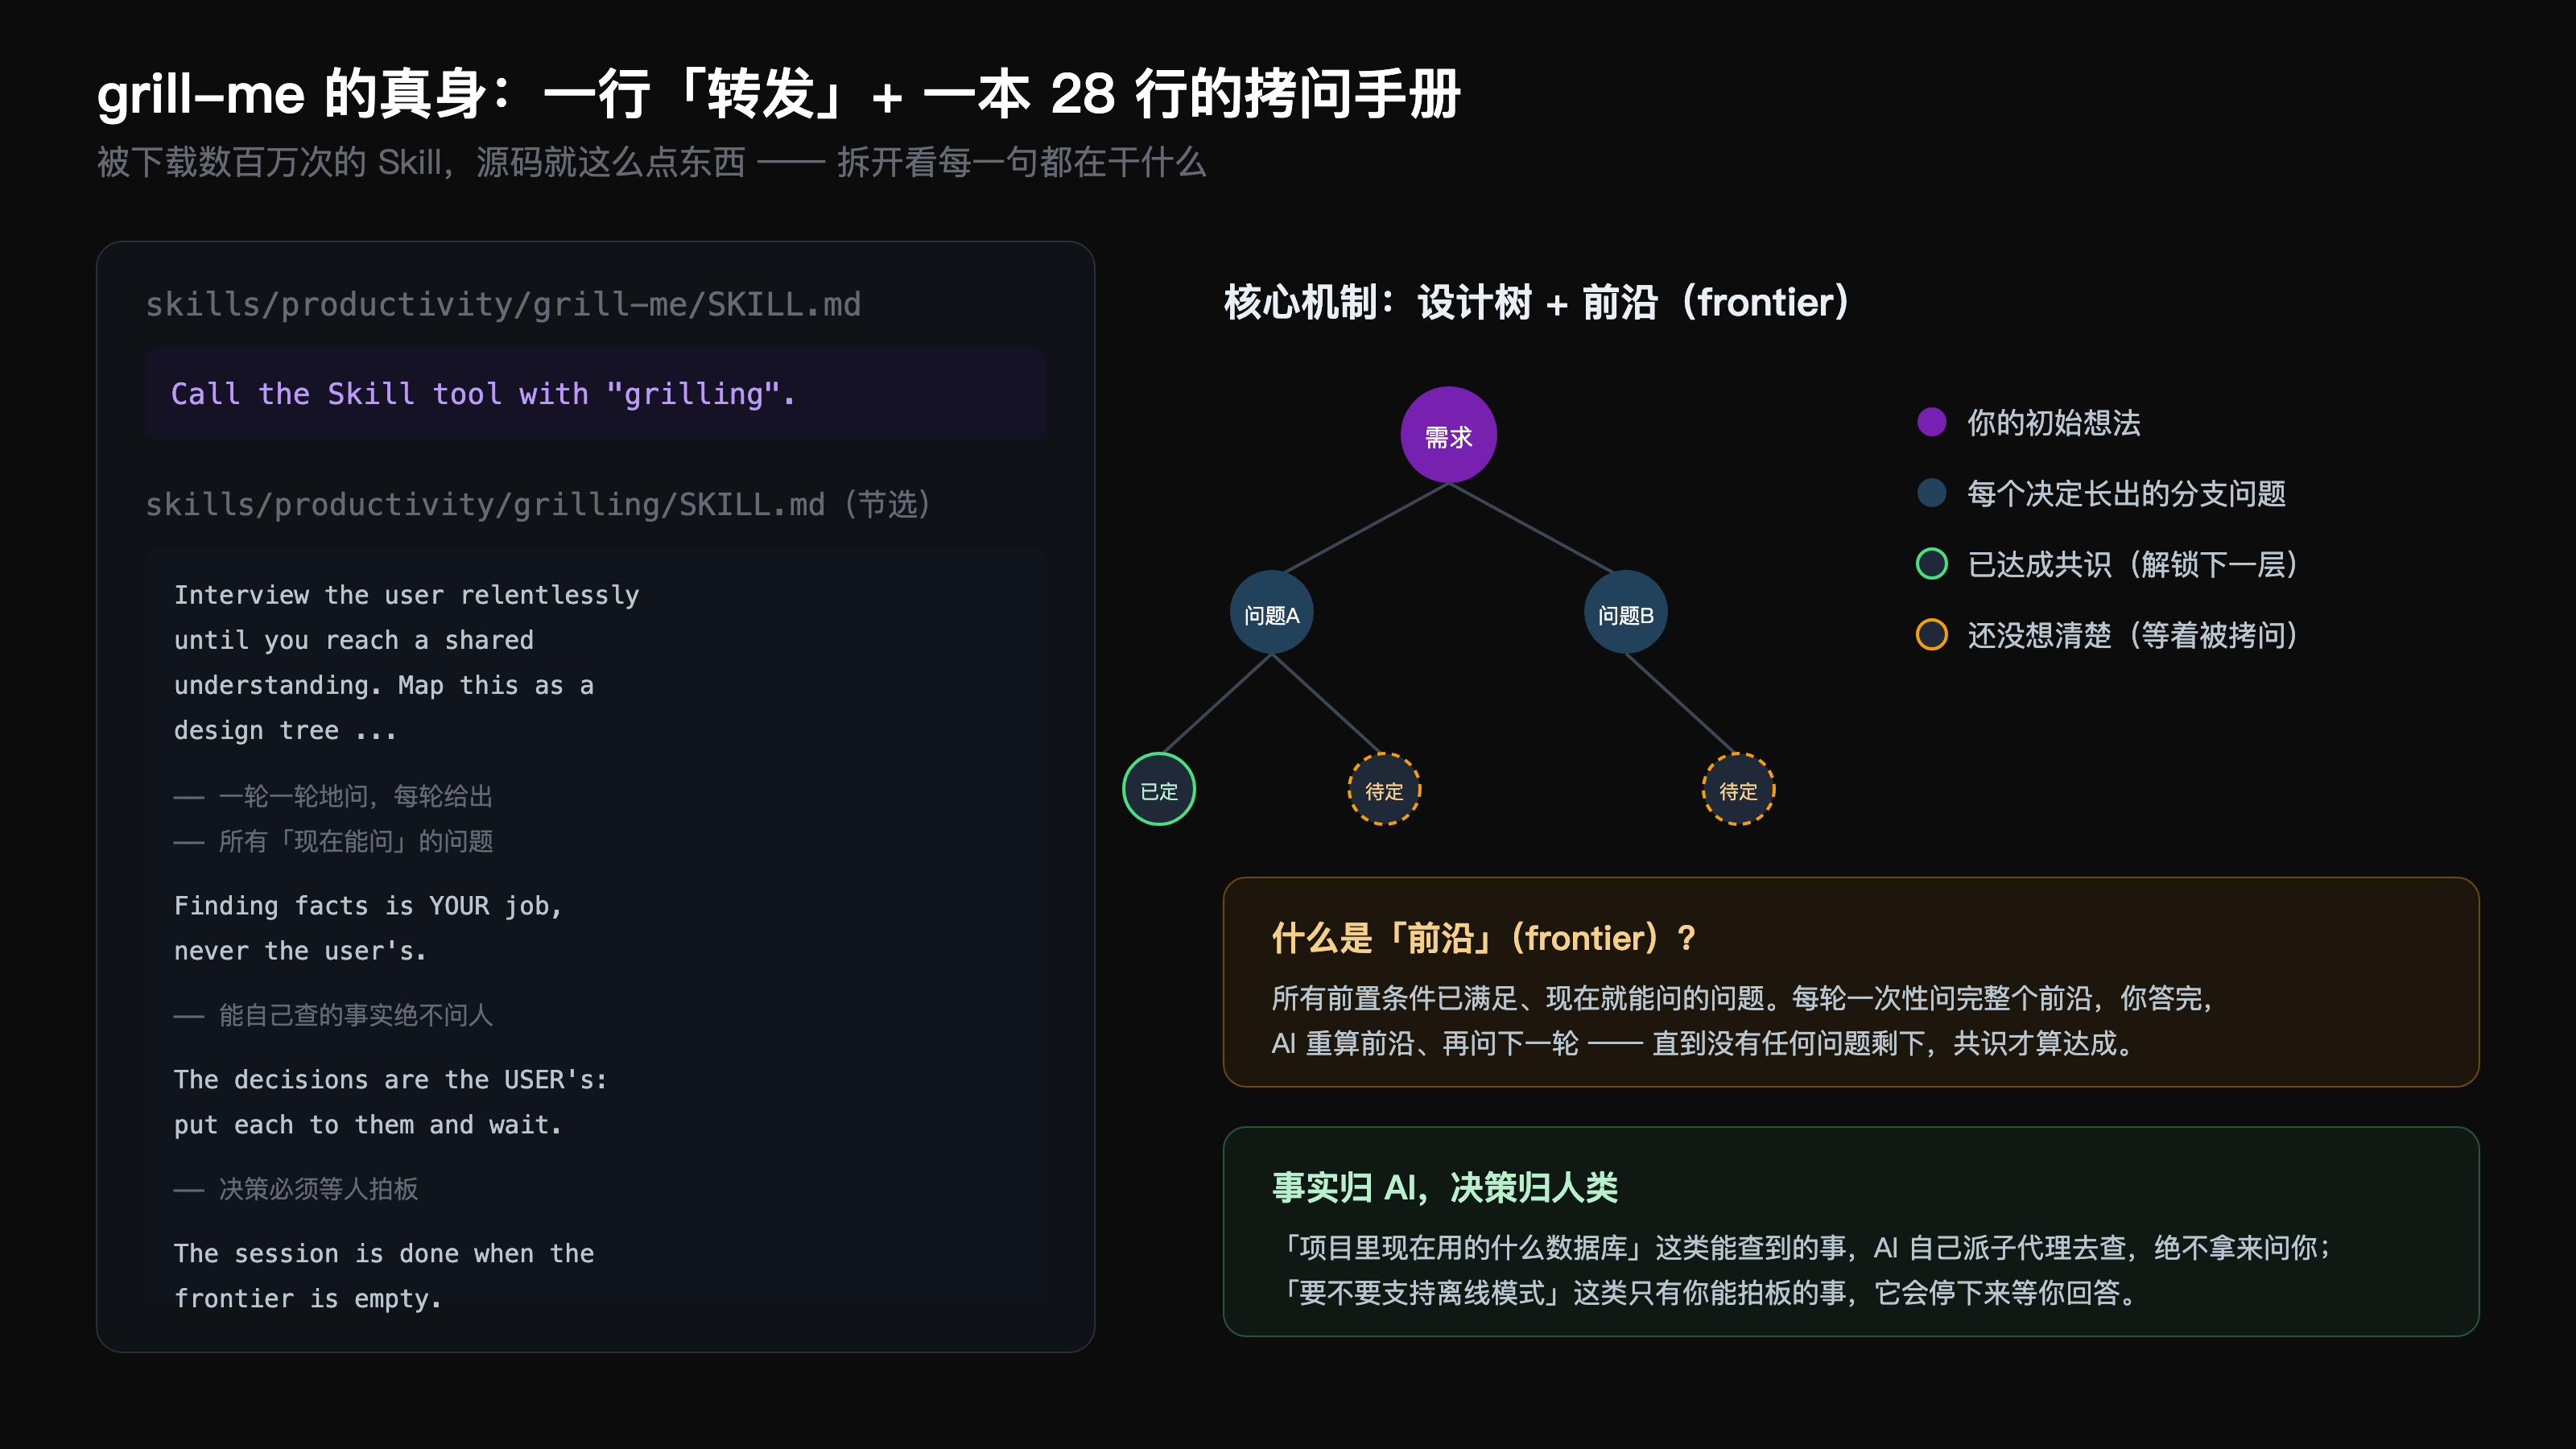
现在打开源码。这个被下载数百万次的 skill,本体只有一行:
Call the Skill tool with "grilling".
就这一行,把控制权转交给一个叫 grilling 的可复用「拷问原语」。真正的拷问规则写在 grilling/SKILL.md 里,总共 28 行。我把关键句原文摘出来,逐句翻译:
# 无情地拷问用户,直到达成共同理解。
# 把整个过程映射成一棵「设计树」:
# 每个决定,都会长出挂在它下面的新决定。
Interview the user relentlessly until you reach
a shared understanding. Map this as a design tree.

# 一轮一轮推进。「前沿」是那些前置条件
# 已全部落定、现在就能问的问题。
# 一轮里问完整个前沿,每题附上你的建议答案,
# 等用户答完再算下一轮。
Work the tree in rounds. The frontier is every
decision whose prerequisites are already settled...

# 找事实是你的工作,永远不是用户的。
Finding facts is YOUR job, never the user's.

# 决策是用户的:把每个决定摆到他面前,等。
The decisions are the USER's: put each to them and wait.

# 前沿为空,会话才结束:设计树的每个分支
# 都被访问过,没有任何东西被默默假设。
# 用户确认共识达成之前,不准动手。
The session is done when the frontier is empty.
四、设计树与前沿:拷问是怎么一轮轮推进的
这 28 行里最值钱的是两个概念。第一个是设计树:你的计划不再是一段笼统的描述,而是一棵决策树。「要做会员系统」是根,「支持哪些登录方式」是它的分支,「密码忘了怎么办」又挂在登录方式下面。AI 的任务是顺着你的思路延伸,把每个决定背后会引发的连锁反应一个个抓出来问到底。
第二个是前沿(frontier),解决提问顺序:一个问题如果它的答案依赖于另一个还没回答的问题,就不许在这一轮问,推到后面。每轮 AI 把「现在能问的」问题一次性编号列出,每个都附上建议答案;你答完,已定的决策解锁下一层问题,AI 重算前沿,再问下一轮,直到没有任何问题剩下。
这里有两个细节值得单独说。一个是「建议答案」:它把拷问从填空题变成判断题。你不需要从零构思完美答案,只需要对 AI 给的推荐说「行」或者「不行,我要的是另一种」,判断成本降到最低,但决策权一步都没让出去。另一个是「事实归 AI,决策归人类」:「项目现在用的什么数据库」这种 AI 自己能查的事实,它会派子代理去查,不会拿来浪费你的时间;而「要不要支持离线模式」这种只有你能拍板的事,它会停下来等你。
还有一个硬性的完成标准:前沿为空才算结束,用户确认共识之前 AI 不准去写代码。这一条直接封死了 AI 最擅长的操作,聊到一半自作主张开始干活。
五、从口头共识到书面规格:to-spec
拷问结束,设计树的每个分支都有了答案。下一步不是写代码,而是把这棵树压成一份书面文件 to-spec。它的定位写得很直白:不再拷问,只做综合。把对话里已经达成的共识整理成一份规格(spec),发布到项目的 issue tracker,打上 ready-for-agent 标签,意思是这份规格已经成熟到可以直接交给 agent 执行。
规格模板里有两处设计值得单独说。一处是它要求一份「极长的」用户故事列表,每条都是「作为某角色,我想要某功能,以便某收益」的格式,拷问阶段挖出来的每个分支,在这里都要落成一个可验收的故事,一个都不能漏。另一处是实现决定里明确禁止贴代码片段和文件路径,原文给的理由很实在:它们会很快过时。规格里只记录「决定了什么」,要新建或修改哪些模块、接口长什么样、schema 怎么变、API 契约是什么,而不记录「代码长什么样」。唯一的例外是原型代码里那种文字说不清、只有代码能精确表达的决定,比如状态机、reducer、类型形状,可以内联进来,但要注明来自原型,且只保留承载决定的那几行,不是完整 demo。这条规则的意思说白了就是:规格是给未来看的决策记录,不是代码快照。
还有一个变体值得一提:grill-with-docs。它的本体也只有两行,同时调用 grilling 和 domain-modeling 两个原语,效果是拷问的同时顺手产出两种文档:ADR(架构决策记录)和领域词汇表。词汇表会写进项目根目录的 CONTEXT.md,之后所有 skill 都被要求使用项目的领域词汇。这就是 README 里「Agent 太啰嗦」的解药:当 AI 和你共享一套行话,它不需要用二十个词去解释一个词能说清的概念,沟通带宽立刻翻倍。而且这套词汇反过来约束 AI:起测试名、写 ticket 标题、做架构建议时都必须用项目自己的词,不许漂移到 component、service 这种谁都能说、但什么都没说的泛称上去。
六、从规格到任务:曳光弹与垂直切片
规格写完了,怎么拆给 AI 执行?Matt 的答案是 to-tickets,核心概念是从《程序员修炼之道》借来的曳光弹(tracer bullet):任务不按层横着切,不是「先做全部数据库,再做全部 API,最后做全部 UI」,而是竖着切,每一片都窄但完整,穿透 schema、API、UI、测试所有层。
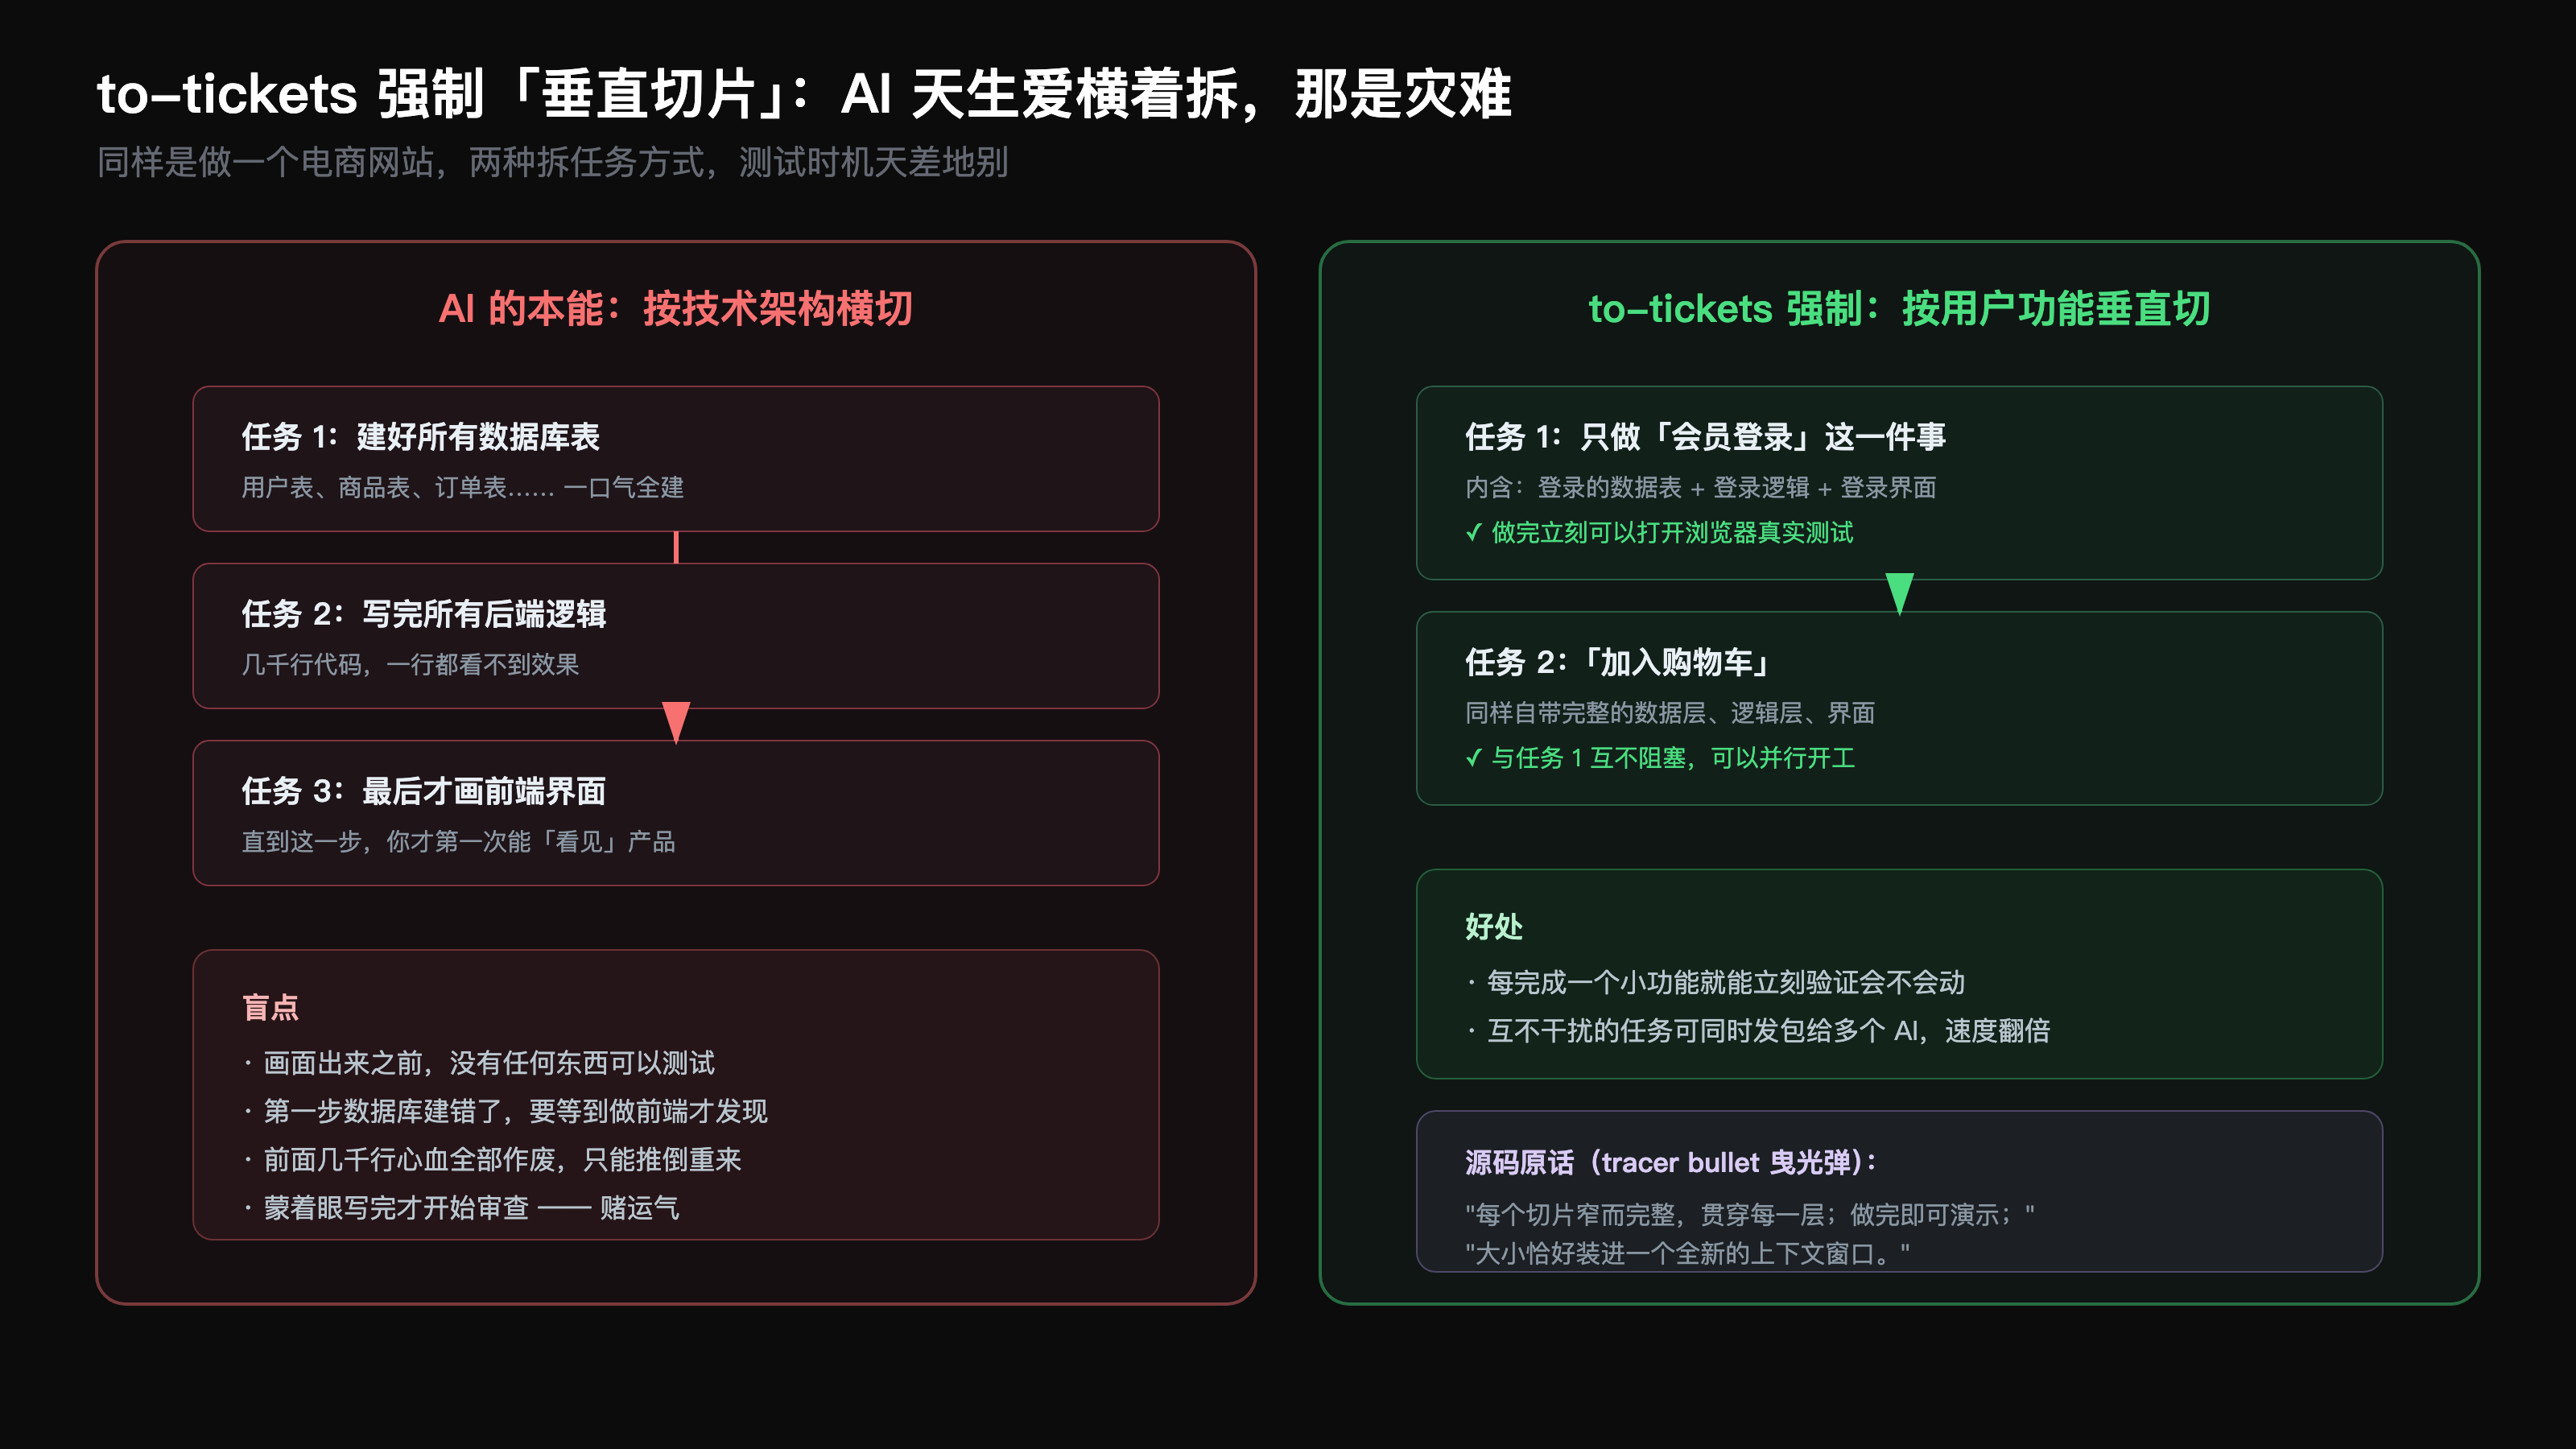
垂直切片规则里最有时代特色的一条是尺寸标准:每个切片的大小以「装得进一个全新的上下文窗口」为准。因为每张 ticket 注定要在一个干净的会话里被 AI 独立执行,切片太大,AI 就顾头不顾尾。另外两条:完成的切片必须能独立演示或验证;任何预重构(prefactor)都要先做。这里还藏了一句软件工程的老话:先把改变变容易,再做那个容易的改变。拆任务之前先让 AI 扫一遍代码库,找机会把即将动手的区域预先理顺。
每张 ticket 还要声明自己的阻塞边(blocking edges):哪些其他 ticket 必须先完成它才能开工。没有阻塞的票可以立刻并行启动,这张依赖图就是后面多个 agent 并行干活时的调度表。拆完之后还有一轮对人的「小拷问」:粒度合适吗?阻塞边画对了吗?有没有该合并或拆分的?反复迭代到你批准,才发布到 tracker。
有意思的是它连例外情况都写好了:大范围重构不适合垂直切片。改一个列名、改一个共享类型这种「爆炸半径」横扫全库的机械变更,一处改动会同时弄崩几千个调用点,没有任何垂直切片能绿灯落地。to-tickets 给的处方是 expand–contract:先「扩张」,让新形式和旧形式并存,什么都不破;再按爆炸半径分批「迁移」调用点,每批一张票、每批都保持 CI 是绿的;最后「收缩」,没人再用旧形式了,一张票删掉它。连这种边界情况都认真处理,是区分「认真写的工作流」和「一段爆款提示词」的地方。
七、动手:implement、TDD 与两条轴的 code-review
到了真正写代码的环节,implement 这个 skill 本身短得惊人:按规格或 ticket 干活,能用 /tdd 就用,类型检查要定期跑、单测文件要定期跑、完整测试套件最后跑一遍,做完用 /code-review 审一遍,然后提交。真正的功夫全在它调用的两个下游里。
tdd 是一份关于红-绿循环的完整参考手册,它先定义了「什么是好测试」:测试只通过公开接口验证行为,读起来要像一句规格。「用户能用有效购物车结账」这种名字本身就是功能说明,而且因为它不关心内部结构,重构随便做,测试永远不碎。接着是「接缝(seam)」的概念:测试只能打在事先约定好的公开边界上,写任何测试之前,先把要打的位置列出来和你确认。你不可能测所有东西,提前对齐接缝,测试力气才会花在关键路径上。
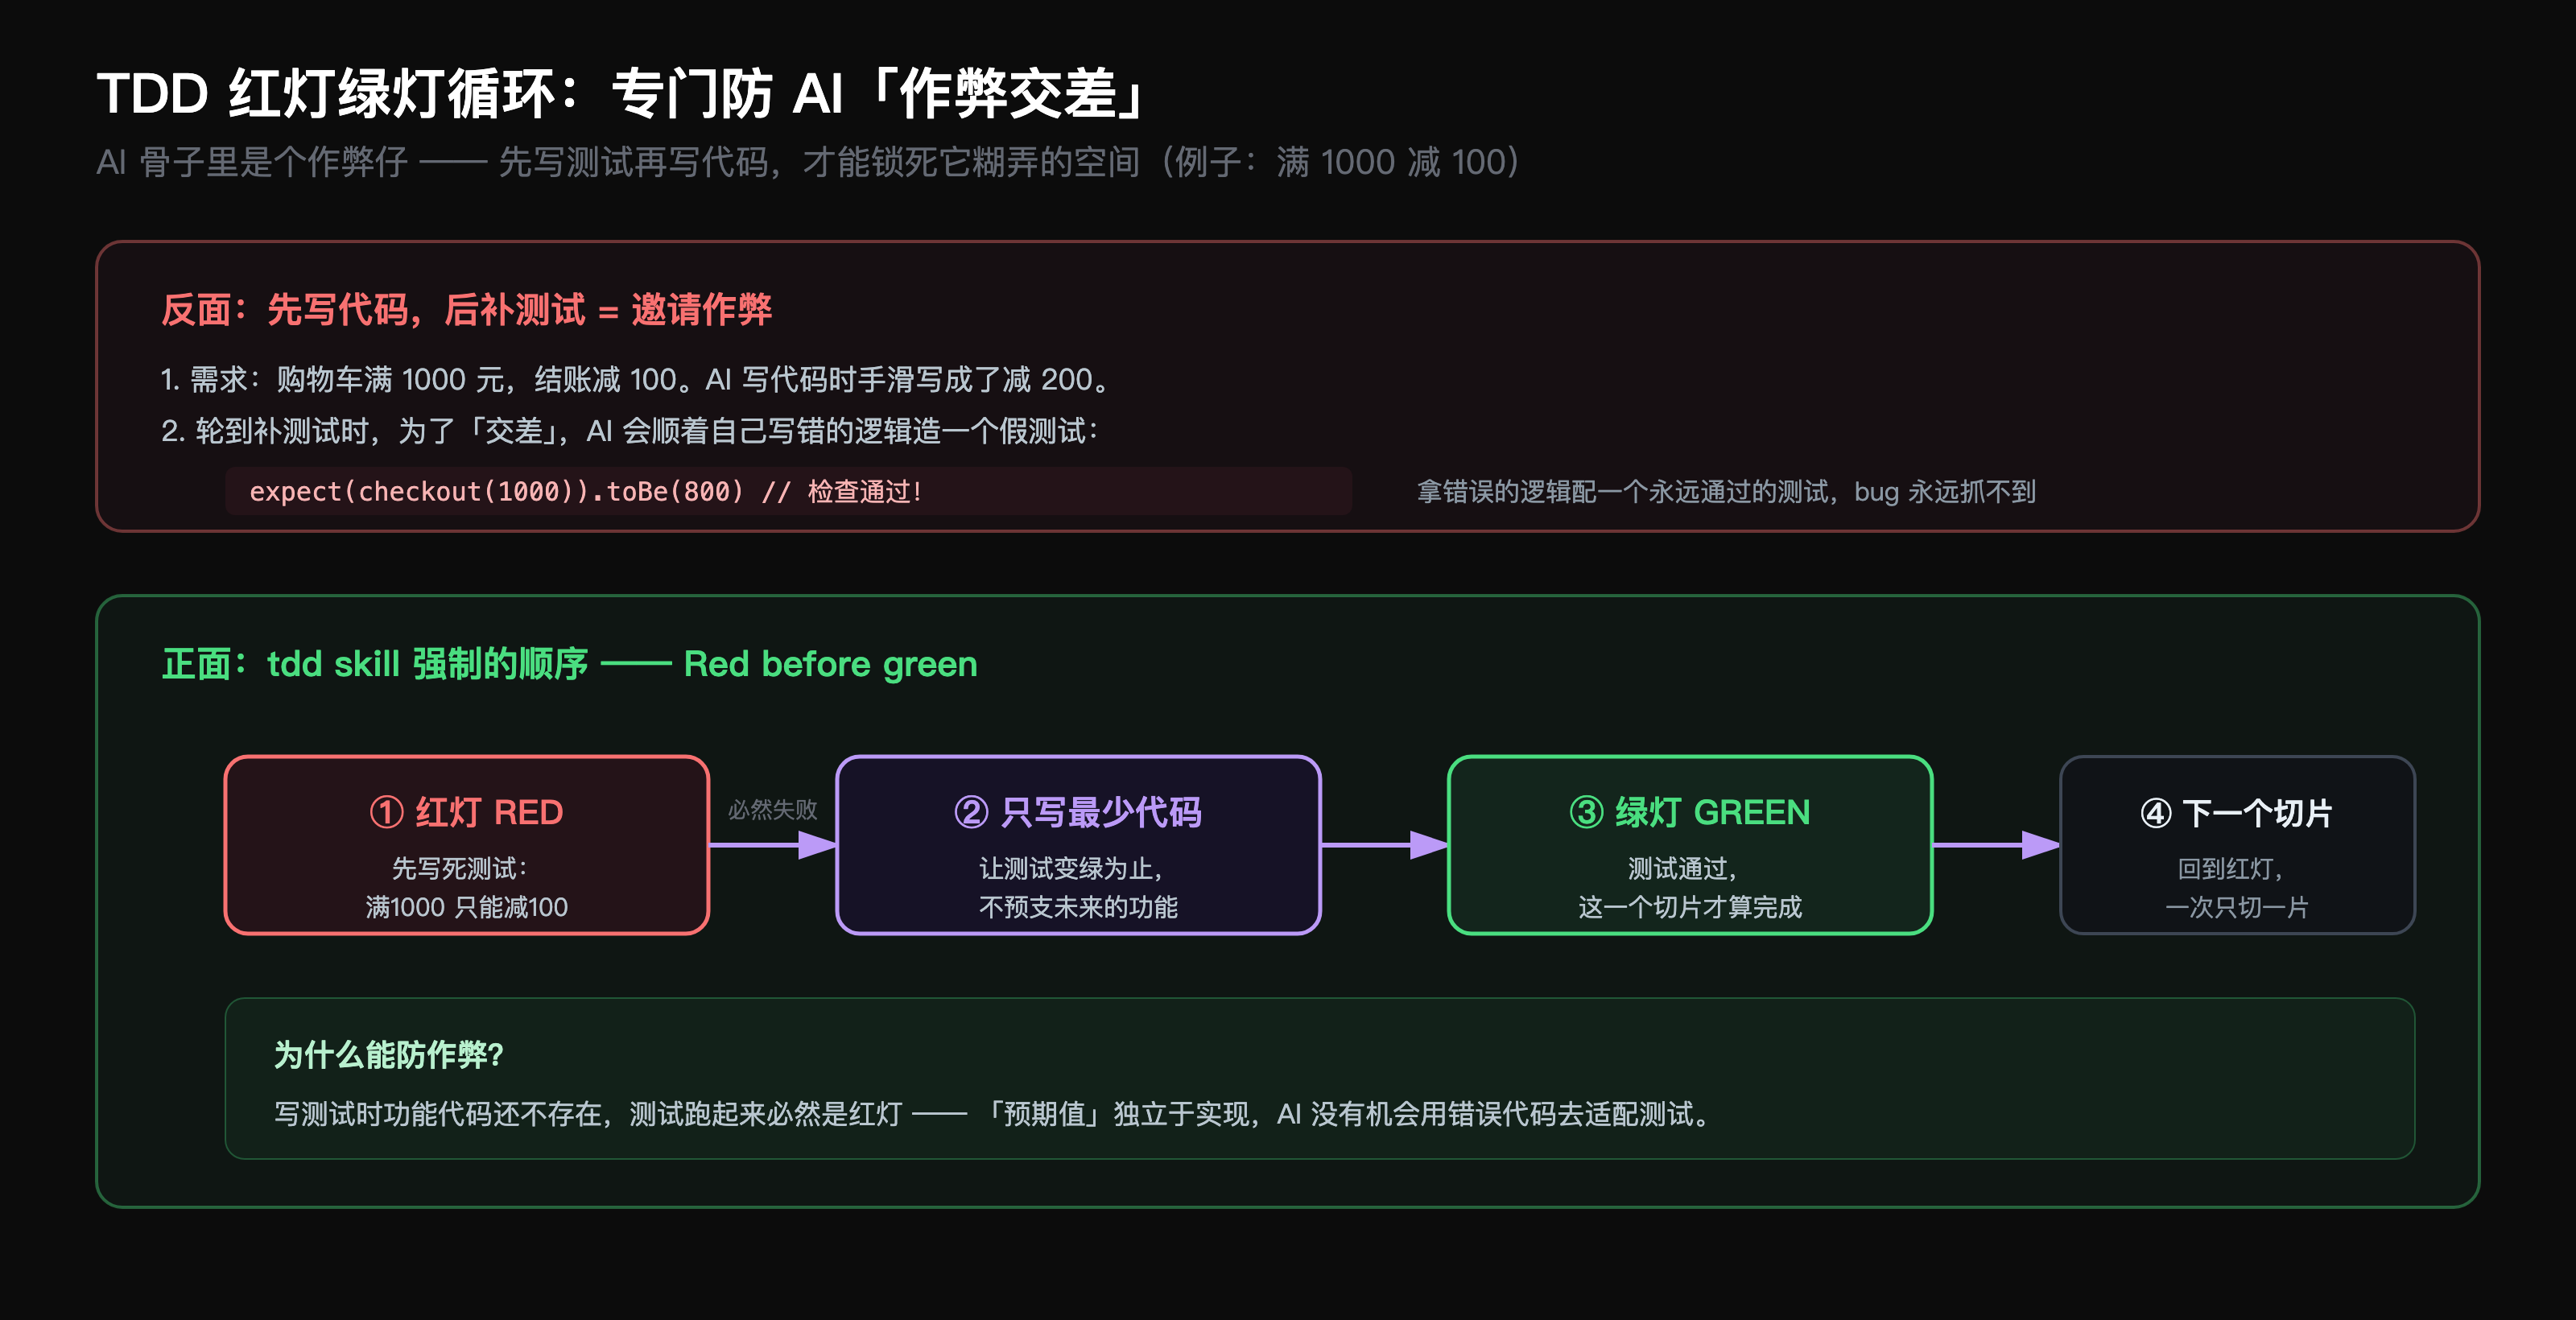
tdd 里我读得最认真的是那份反模式清单,条条都带「识别特征」。实现耦合:mock 了内部协作者、测了私有方法、绕道查数据库验证,识别特征是「行为没变,重构却让测试碎了」。同义反复:断言用和代码一样的方式重算期望值,比如 expect(add(a,b)).toBe(a+b),这种测试按构造永远通过,永远不会和代码吵架,期望值必须来自独立的事实源:已知正确的字面量、手算过的例子、规格本身。水平切片:一口气写完所有测试再一口气写实现,批量测试验证的是「想象中的行为」,你在还不理解实现的时候就锁死了测试结构。这些都是 AI 写测试时最容易犯的错,写进 skill 里,等于给 agent 装了护栏。
最后是 code-review:对「当前 HEAD 到你指定的固定点」之间的 diff 做双轴审查。Standards 轴问「代码符不符合这个仓库的编码规范」,除了仓库自己的 CODING_STANDARDS.md 之类,它还内置了一份「坏味道基线」,就是《重构》第三章里 12 种 Fowler 代码坏味道,每条都是「是什么 → 怎么修」,哪怕仓库什么规范都没写也能审;两条纪律:仓库规范永远优先于基线,且坏味道永远是判断题不是硬违规。Spec 轴问「代码有没有忠实实现当初的规格」:规格要的功能有没有漏?有没有规格没要求的多出来的东西(scope creep)?有没有实现了但实现错的需求?
两轴各派一个子代理并行跑,互不污染上下文,报告并排呈现、不合并重排。原因很实在:一次改动完全可能「规范全过、方向全错」,或者「方向全对、规范全破」,分开报告才能防止一个轴的通过掩盖另一个轴的失败。
八、给代码库做大扫除:深模块与删除测试
AI 写代码快,熵涨得更快,所以这套工作流还有一个定期执行的「体检」命令:improve-codebase-architecture。它的目标很聚焦:找出代码库里的「深化机会(deepening opportunities)」,也就是把浅模块变深的重构,换来更好的可测性和「AI 可导航性」。注意后一个词:架构好坏的标准里,已经明确包含「AI 能不能轻松读懂这个代码库」了。
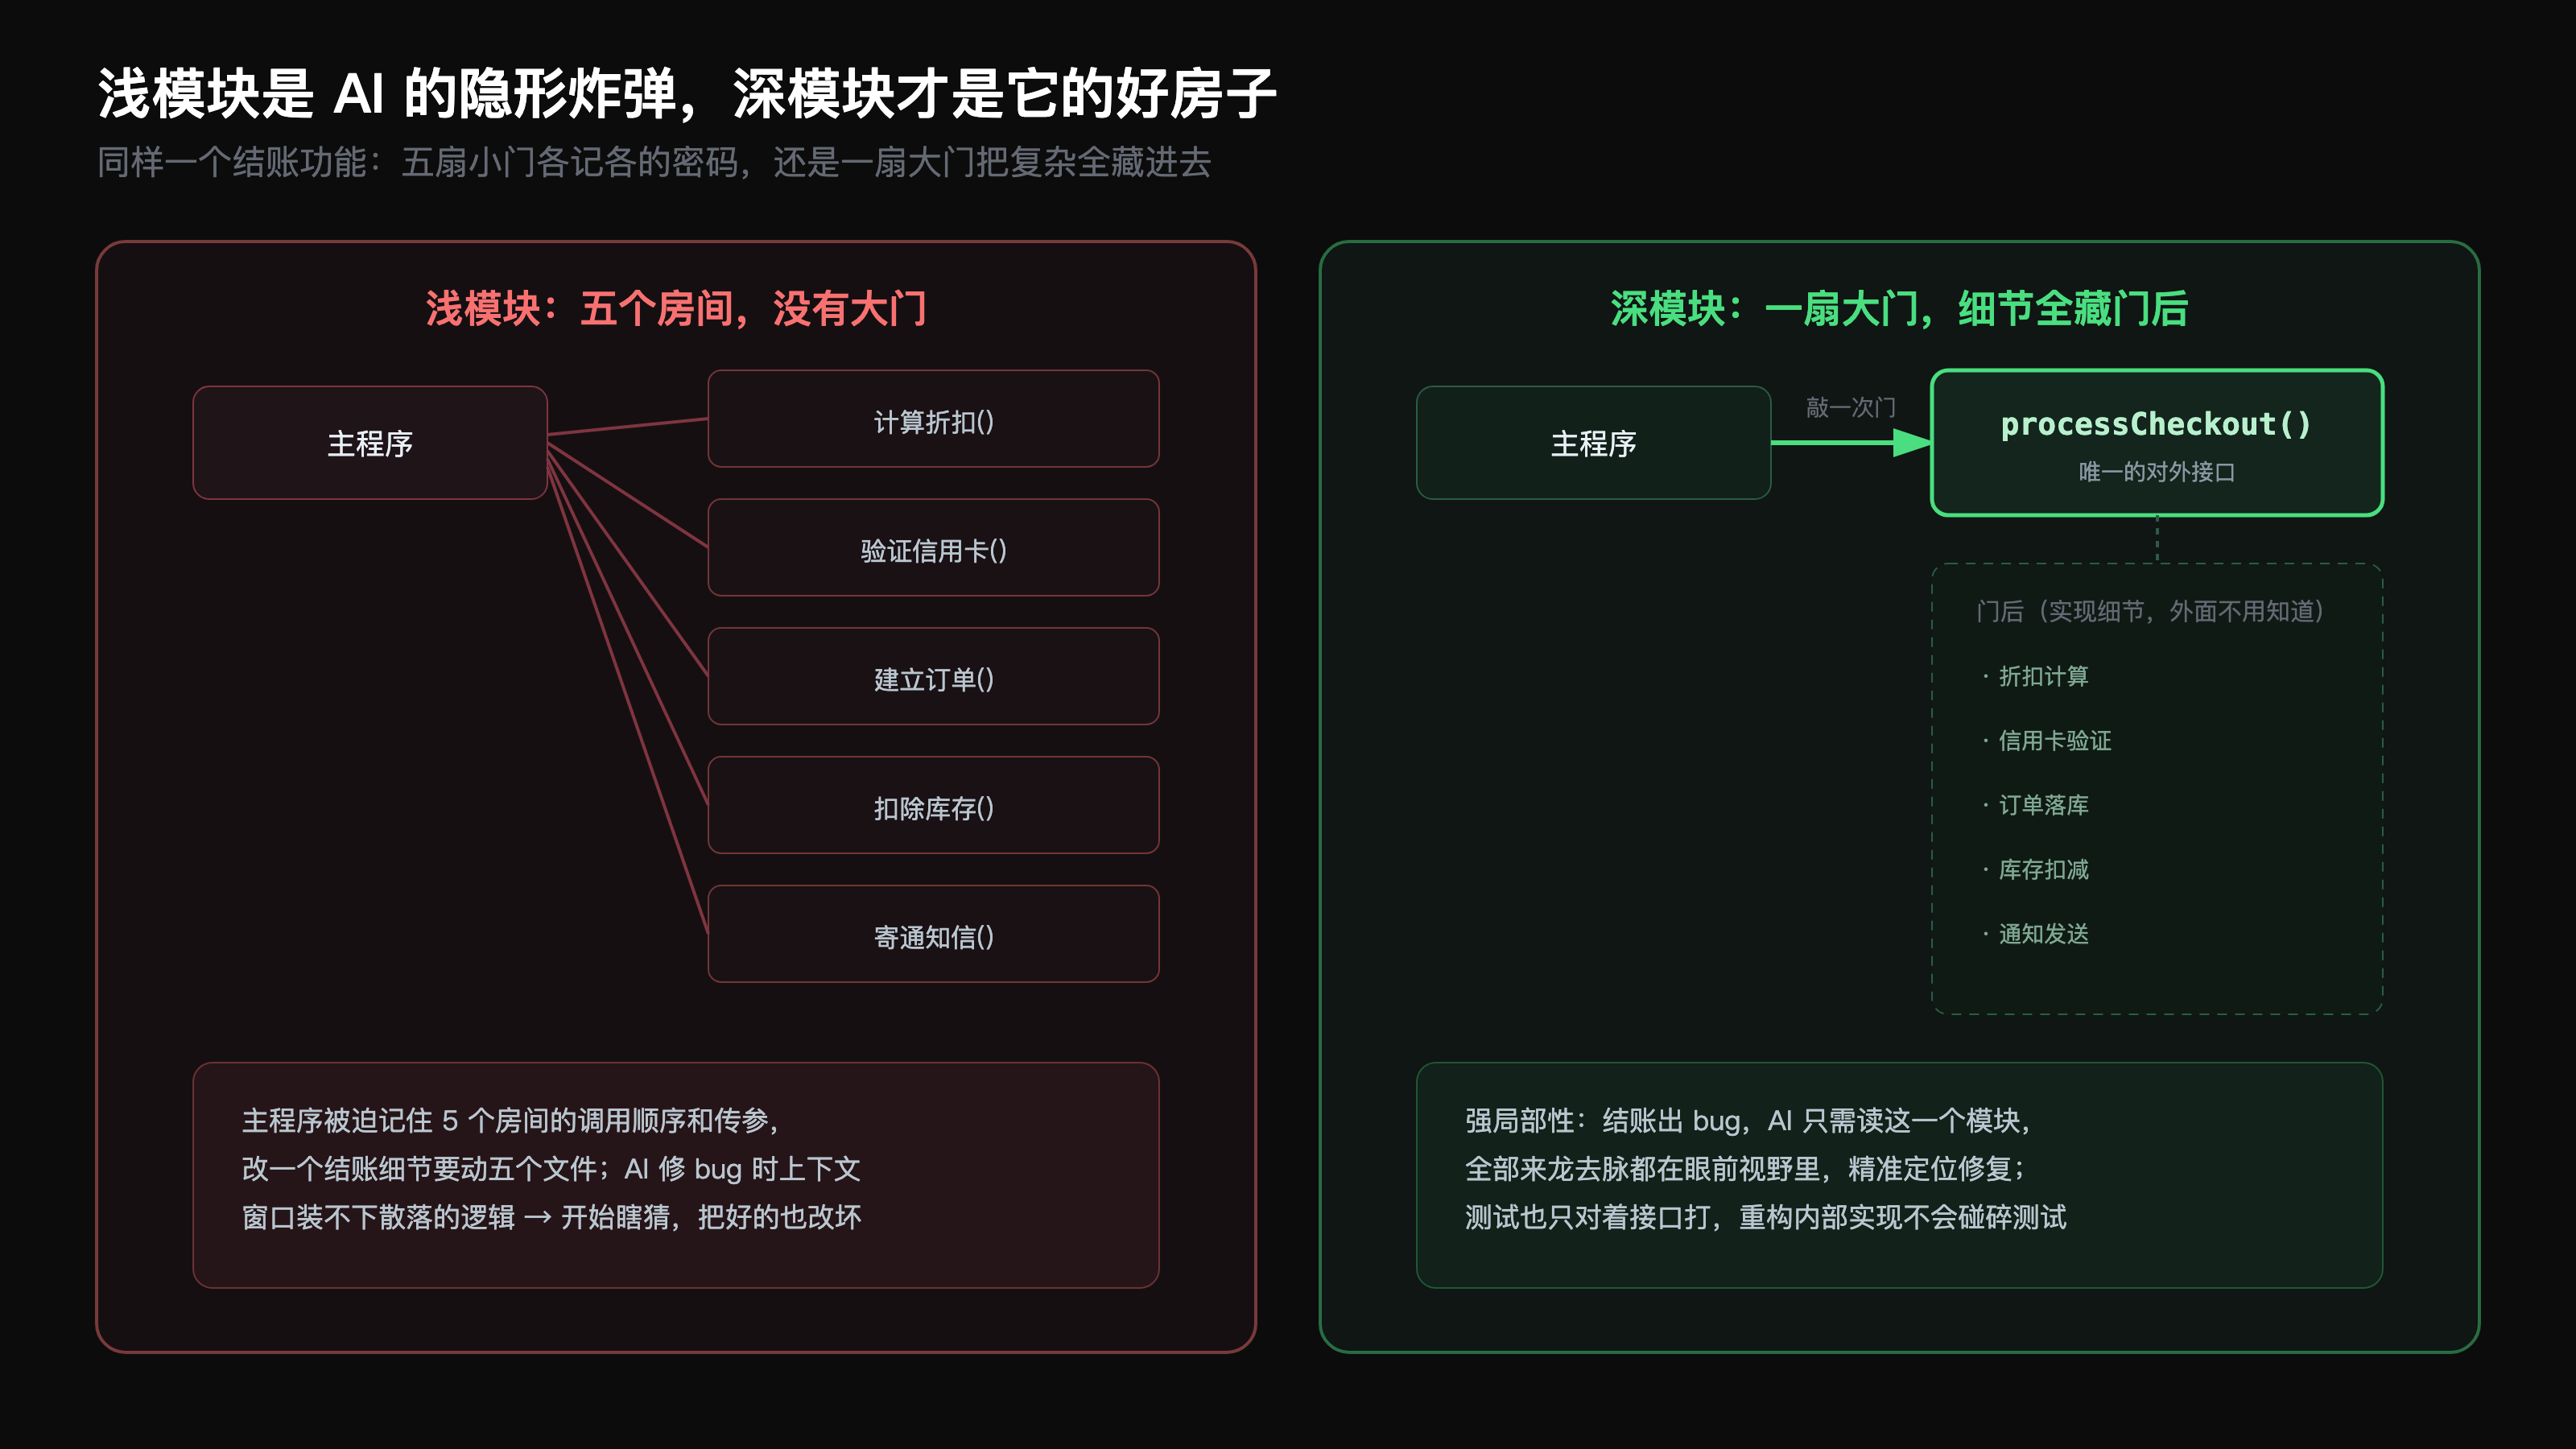
「深模块」来自 John Ousterhout 的《软件设计哲学》:深模块用一个小接口藏住一个大实现,调用者付一点学习成本,之后一路占便宜;浅模块则相反,接口几乎和实现一样复杂,用它等于什么都没省。skill 先圈定扫描范围,按 YAGNI 原则:深化只在「未来还会继续改」的地方才有回报,所以优先扫 git 历史里的热点区,也就是最近反复被改的文件。然后派子代理在代码库里走一遍,记录所有摩擦点:理解一个概念要在十几个小模块之间来回跳?某个模块的接口和实现差不多复杂?为了可测性抽出来的纯函数,真正的 bug 却藏在「怎么调用它」里(缺乏 locality)?
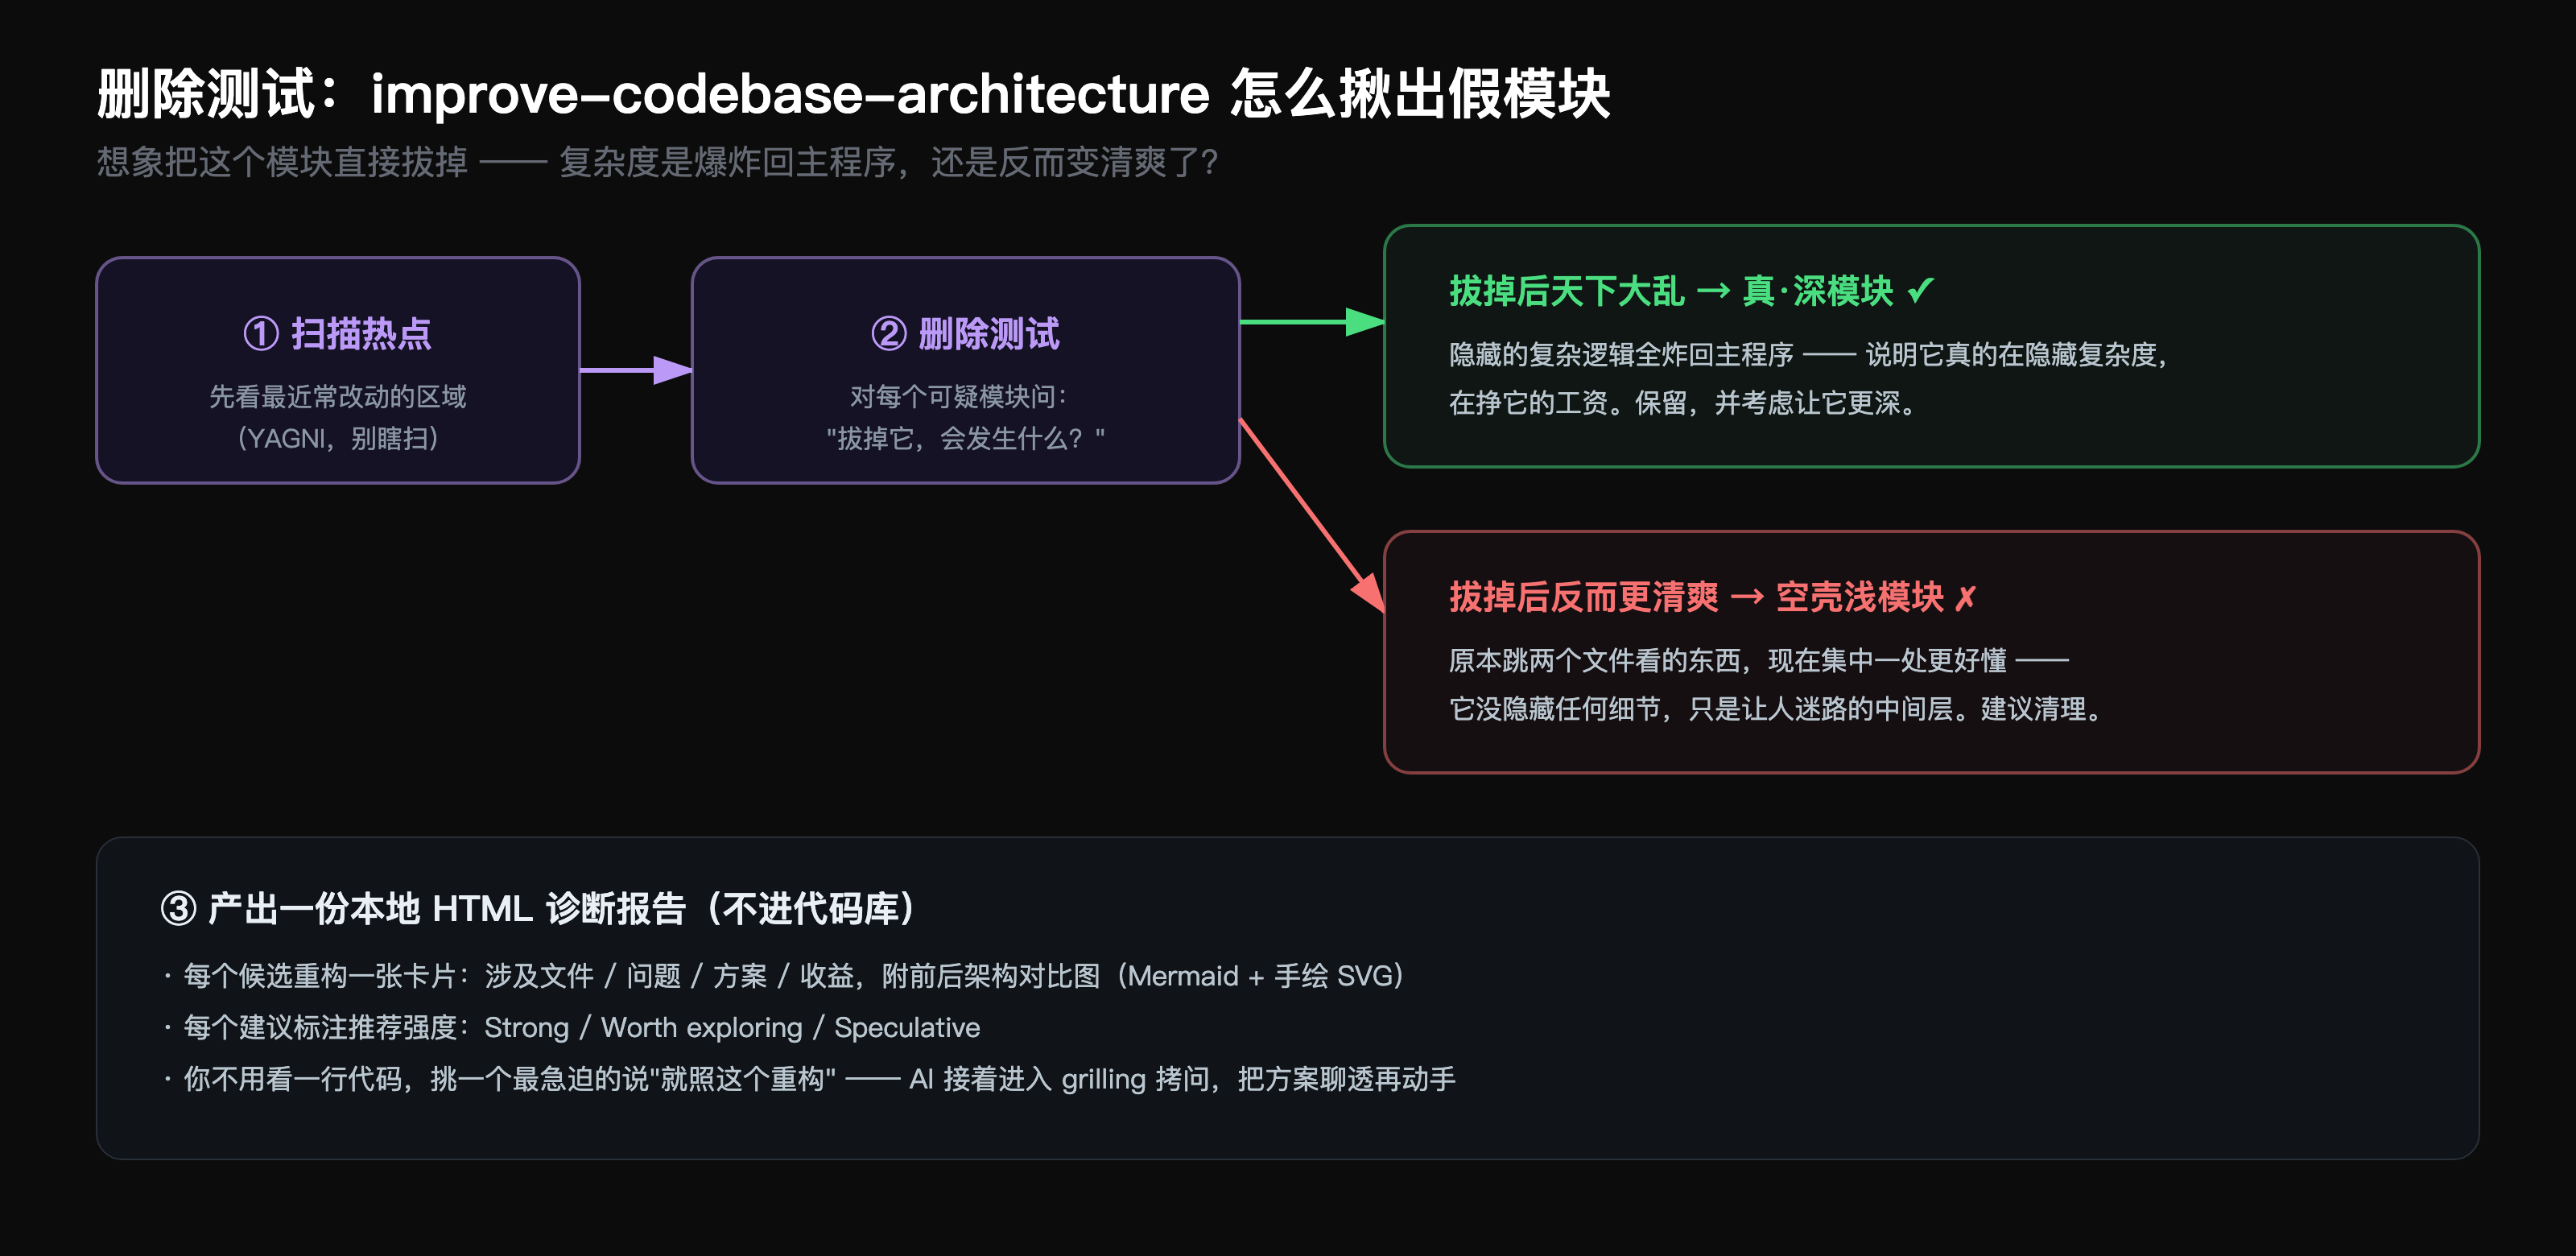
对每个疑似浅模块,用「删除测试」过一遍:假设把它删掉,复杂度是被收拢进了更深的模块,还是只是搬去了别处?只是搬家的,就是假的抽象。最后产出是一份本地 HTML 可视化报告,列出所有深化机会,结尾还有一个设计:你挑一个机会,它会对你挑的那项再跑一轮 grilling。整个流水线在这里闭环,大扫除找出的每次重构,都要先过一遍拷问才允许动手。
九、元技能:怎么给 AI 写文档
仓库里还有一个不直接产出代码的 skill:writing-for-agents,讲写给 agent 看的文档(skill、AGENTS.md、CLAUDE.md)该怎么写。这是整套项目的方法论底座,也解释了为什么每个 skill 都这么短。
第一个概念是上下文指针(context pointer)。skill 的 description、AGENTS.md 里指向某个文档的那一行,都是指针:它们给不在场的材料命名,并编码「什么时候该去读它」。这里最关键的结论是,决定 agent 会不会去读材料的,是指针的措辞,不是材料本身。一个必读材料挂在一条措辞含糊的指针后面,就是一个方差 bug。所以指针的写法很讲究:触发词前置,指针的开头就是它干活的地方;每个分支只写一个触发,同一个场景的同义改写是写了两遍的废话,要合并;删掉正文已经承载的身份信息。因为常驻上下文的指针每个回合都在花钱,它比正文还要狠剪。
第二个概念是两种负载。上下文负载是常驻材料的成本:AGENTS.md 的每一行、每个 skill 的 description,不管用不用,每个回合都在烧 token 和注意力。认知负载是人的成本:项目里有哪些文档、什么时候该去翻哪一份,人是索引。作者特别强调认知负载不是要最小化的敌人,而是「人类掌控权的代价」:在需要人类判断的地方花它,在不需要的地方消除它。
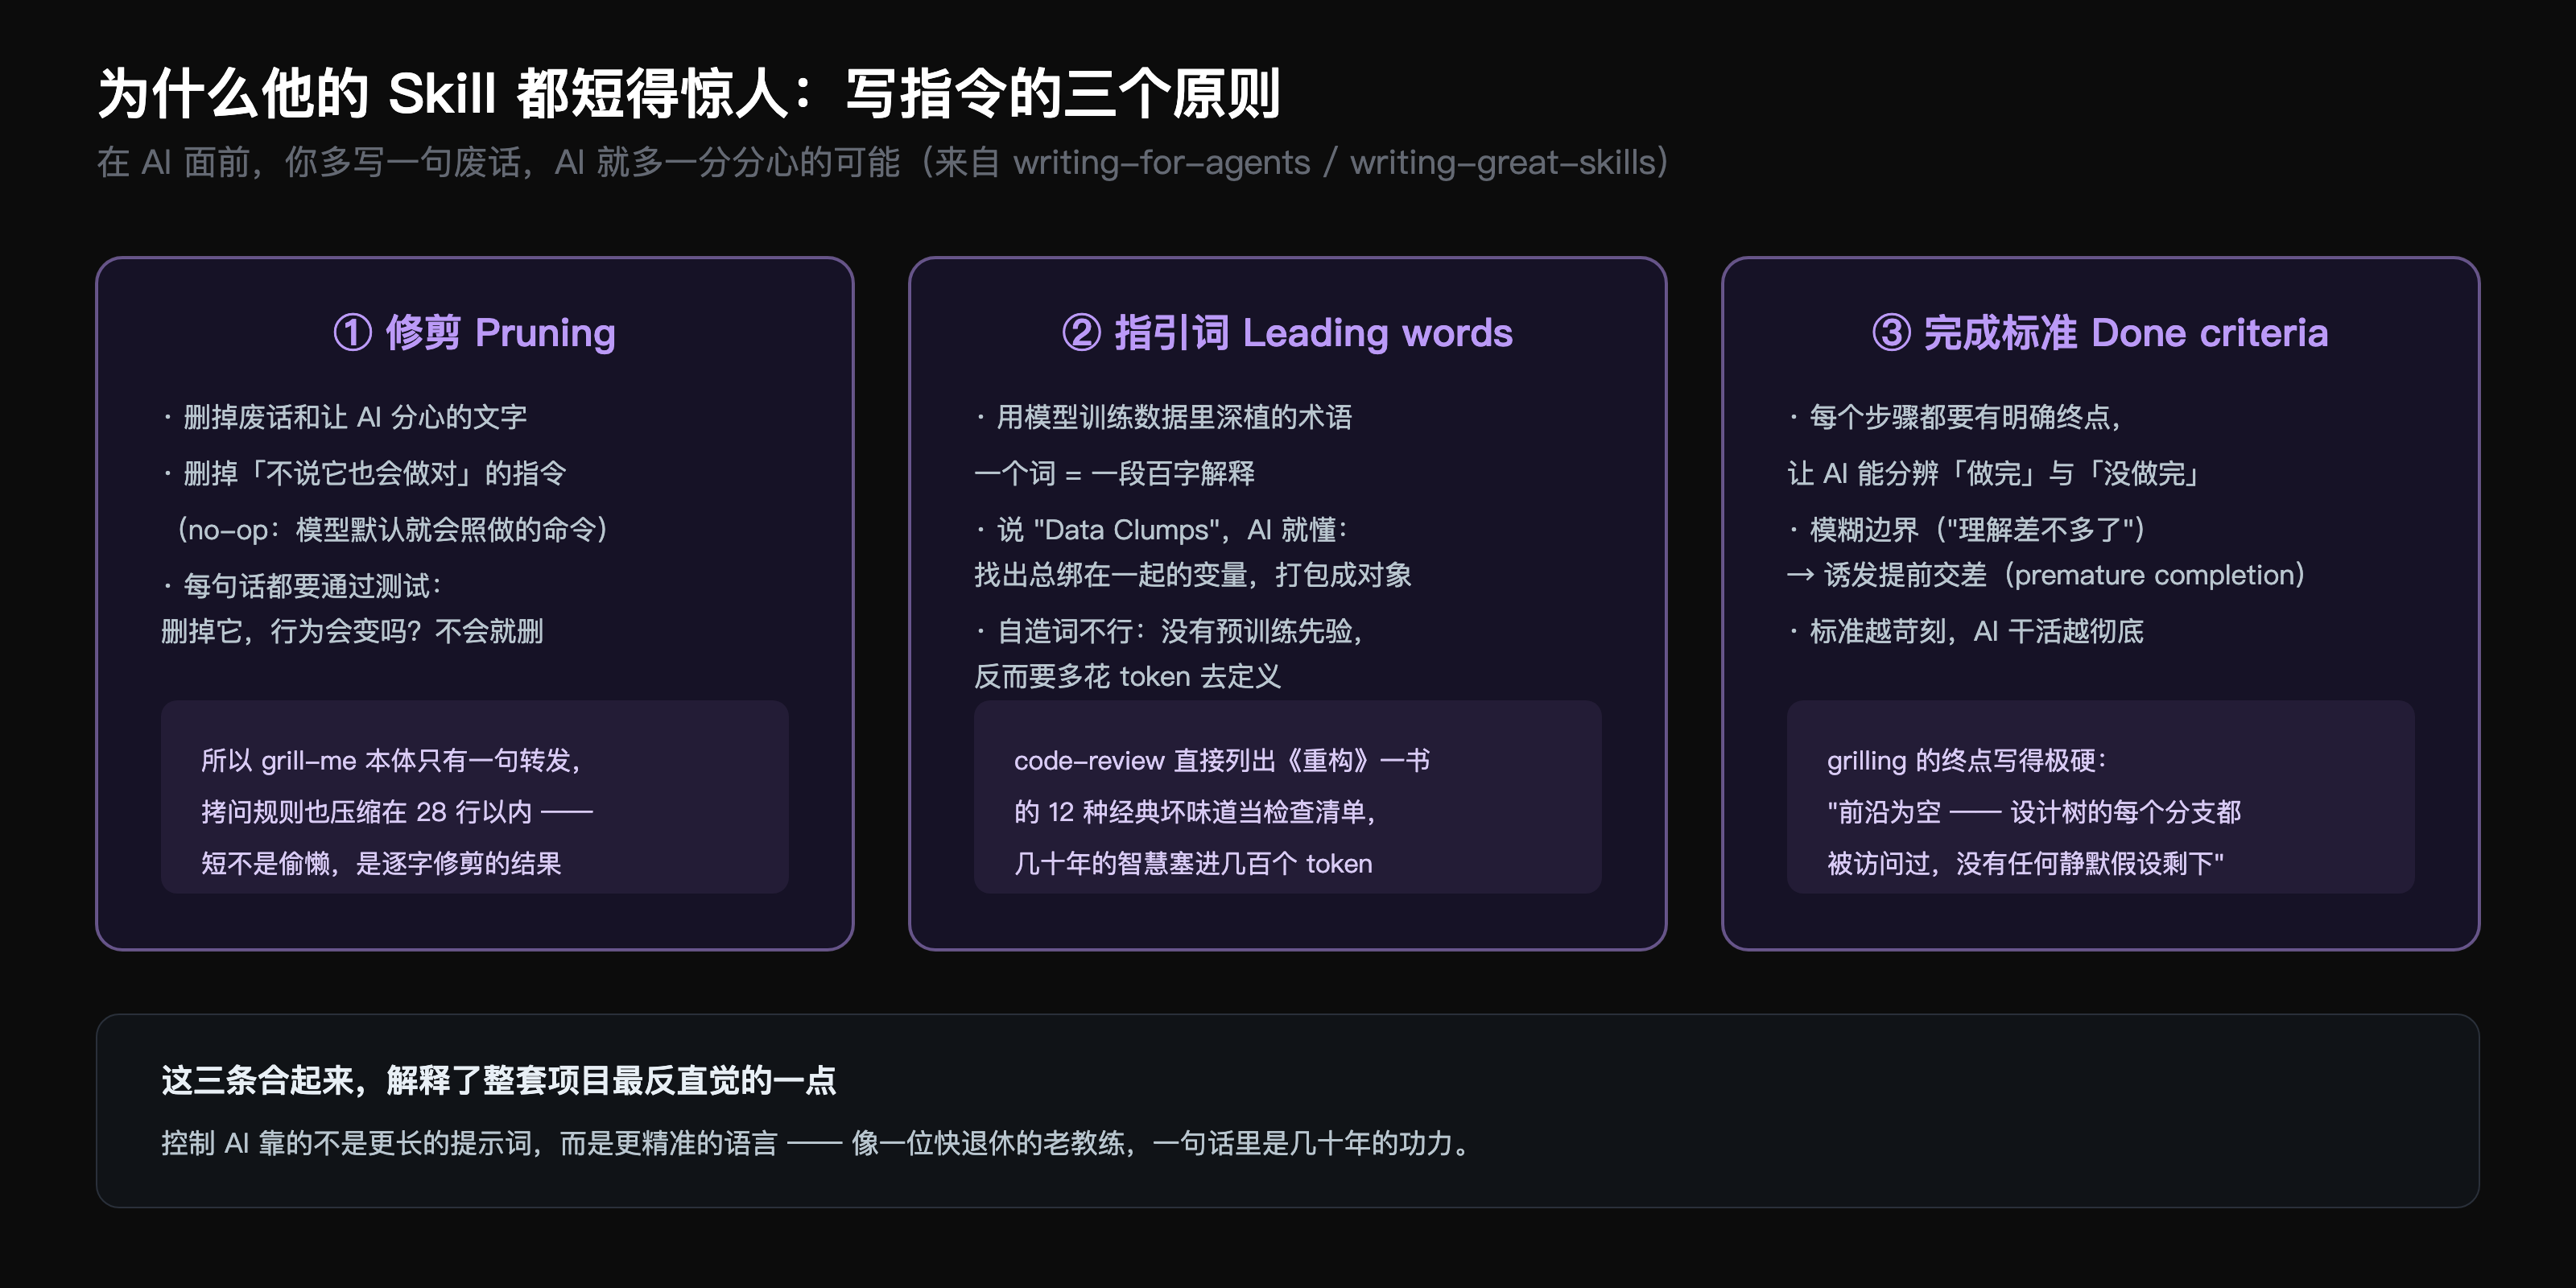
第三个概念是信息层级。材料按「agent 多快需要它」排梯子:文件内的步骤是第一层,agent 每次执行的路线;文件内的参考按需查阅;指针指向的文件逃出上下文负载,只付指针那一行的钱。回头看,grill-me 自己就是这套写法的示范:一行路由指针把常驻成本压到极限,28 行的 grilling 原语只装「每次执行的路线」,其余一切按需加载。它不是懒得写长,是刻意短。
十、怎么用:30 秒安装与日常流水线
说完了原理,落到实操。README 管安装叫「30 秒设置」,两条路代表两种哲学,二选一(都装会出现双份):
# 方式一:Claude Code 插件 —— 托管只读,随作者更新
claude plugins install mattpocock-skills

# 方式二:skills.sh 安装器 —— 任何 agent 可用(含 Codex),
# 拷成你自己拥有的可编辑文件
npx skills@latest add mattpocock/skills
方式一是「订阅」:整套 skill 以托管包形式安装,Matt 发新版你自动收到,适合想开箱即用的人。方式二是「fork」:安装器把 skill 当成普通文件写进你的仓库,归你所有、随便你改,没有后台更新,想同步就手动 npx skills update。用方式二时,安装器会让你勾选要哪些 skill,记得勾上 setup-matt-pocock-skills,它负责配置 issue tracker 和 triage 标签词汇;Codex 原生插件也在路线图上。装完在项目里跑一次 /setup-matt-pocock-skills,就全部就绪了。
日常使用的流水线长这样:
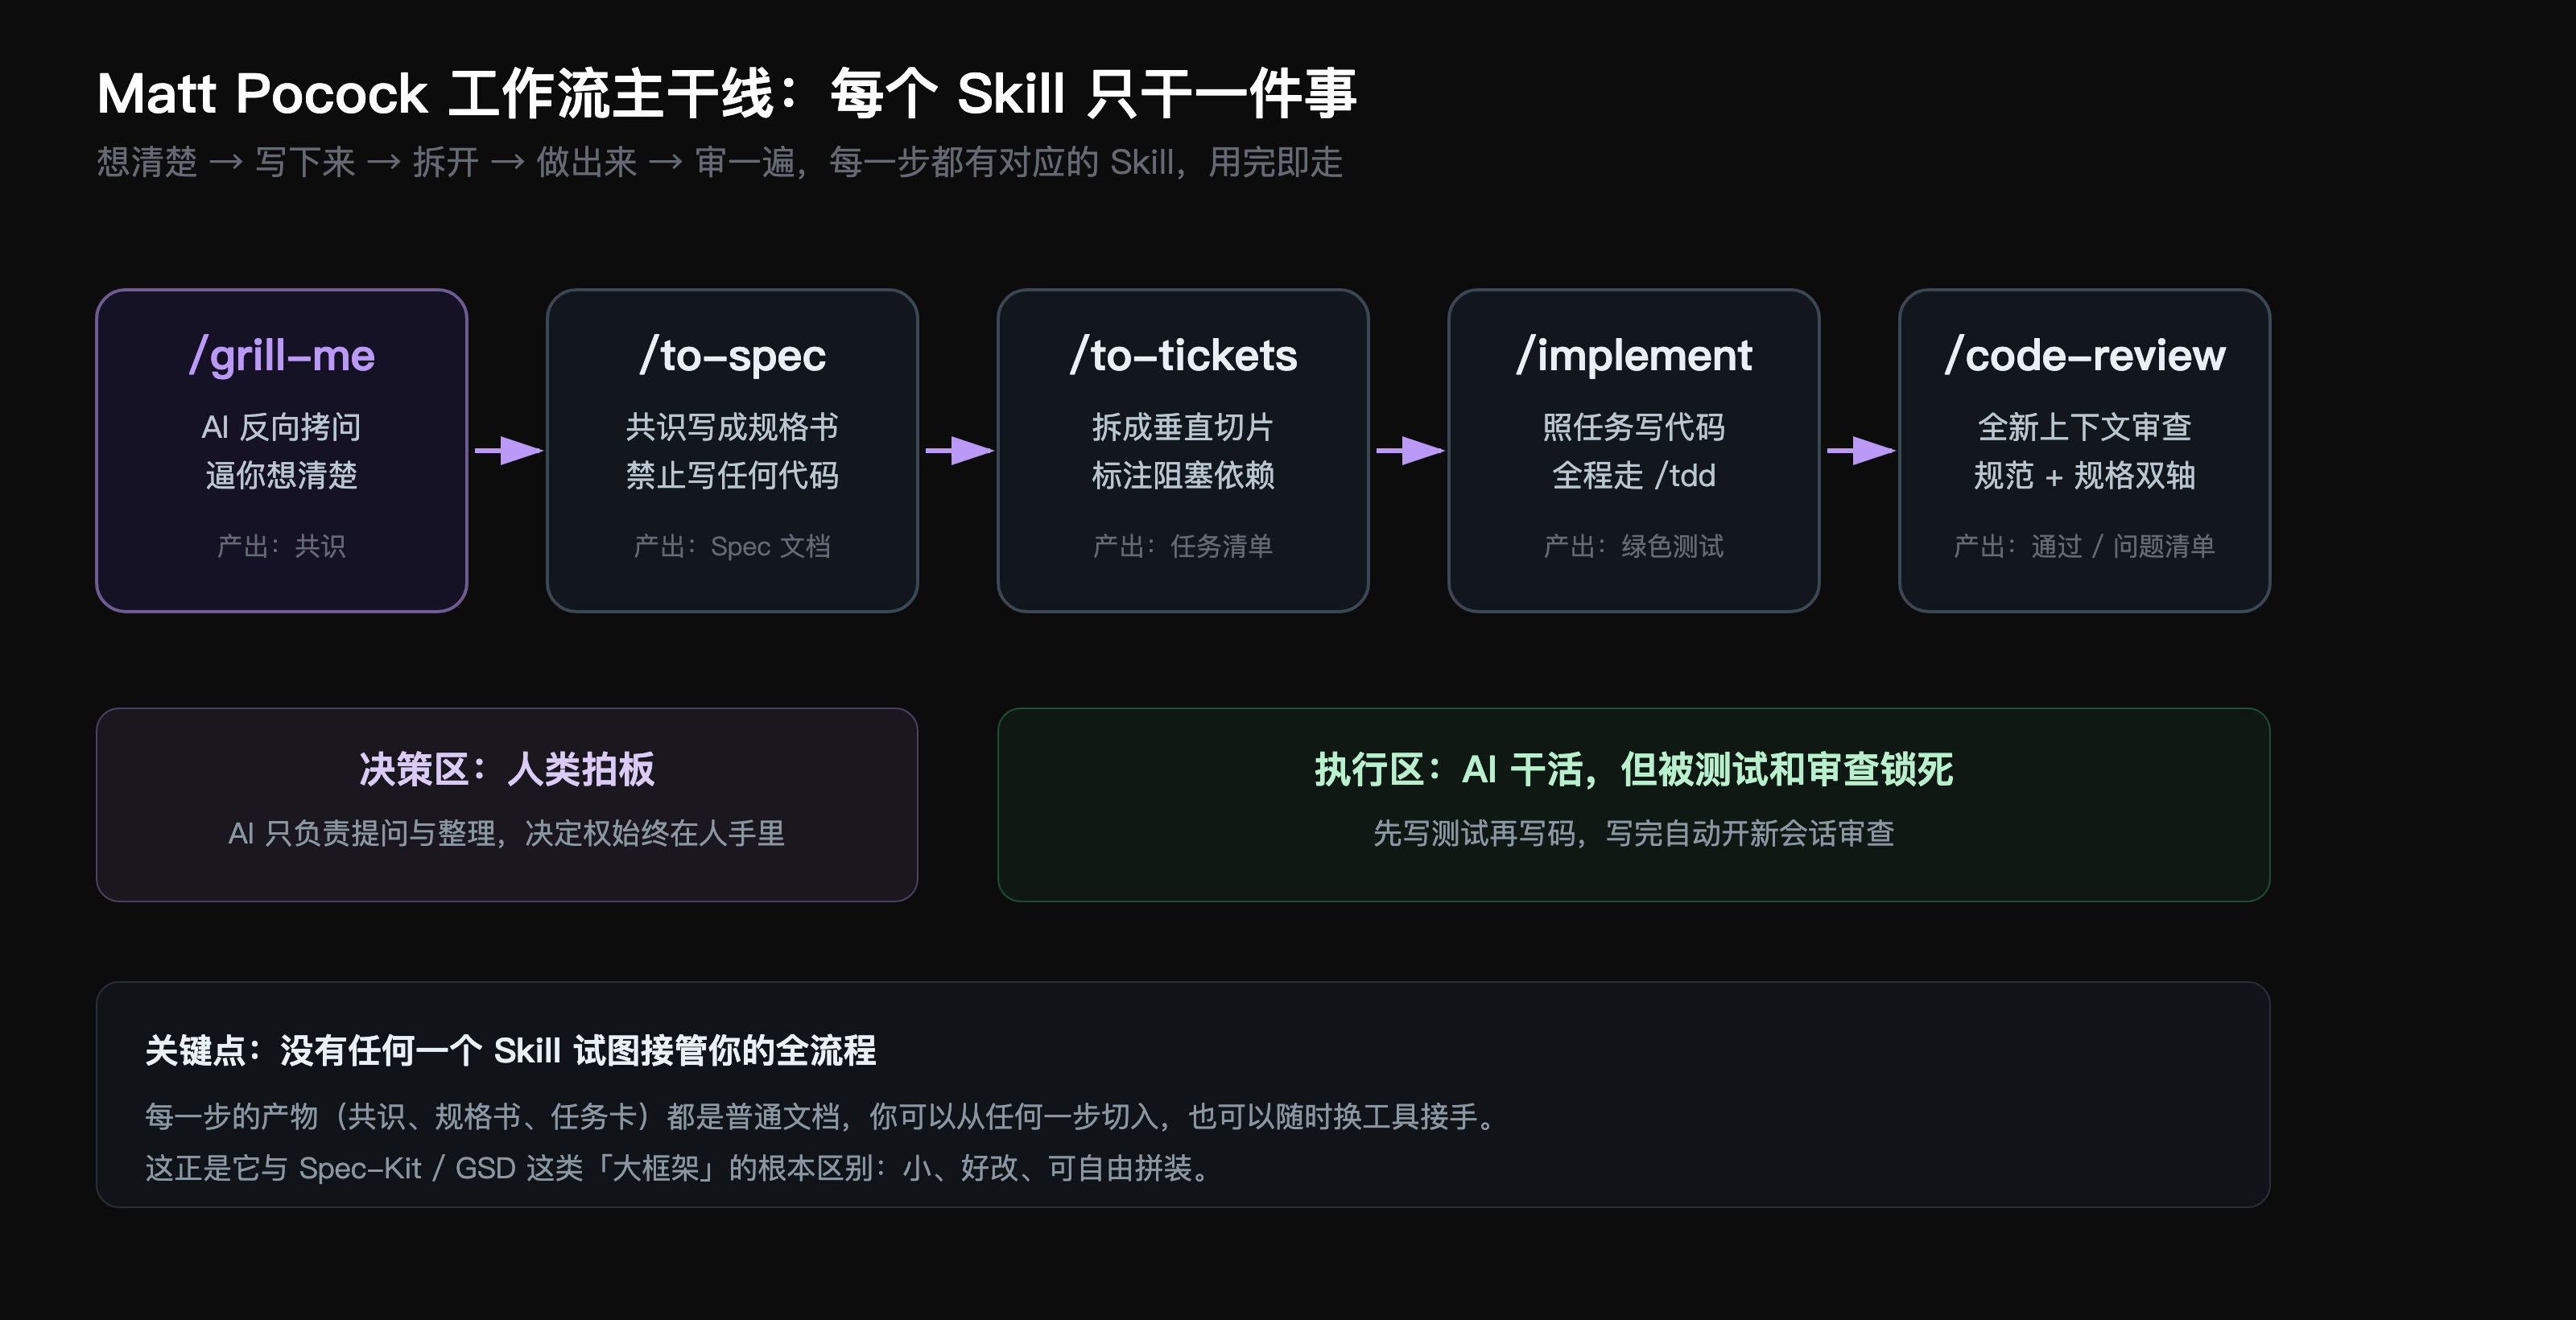
接到一个模糊需求,先 /grill-me 被拷问到前沿清空(要沉淀文档就用 /grill-with-docs);然后 /to-spec 把共识压成规格;/to-tickets 把规格切成带阻塞边的垂直切片;每张票交给 /implement,里面自动带 TDD;完成后 /code-review 双轴过一遍再合入。隔段时间跑一次 /improve-codebase-architecture 做大扫除,挑出来的重构再回到拷问环节。至于什么时候该用:新功能、说不清的需求、大重构之前、接手一个你还没完全理解的领域,都先拷问一轮;改个错别字这种小事直接改就好。作者自己写的小工具都带着 disable-model-invocation 标记,意思是只在人明确要求时启动,这套东西从不主动打扰你。
十一、和 Superpowers 比:两种驯化 AI 的哲学
最后做一个对比:GitHub 上另一个更火的 AI 工作流仓库是 Jesse Vincent 的 obra/superpowers(约 27.6 万星,比 Matt 的还多)。两者方向相反。
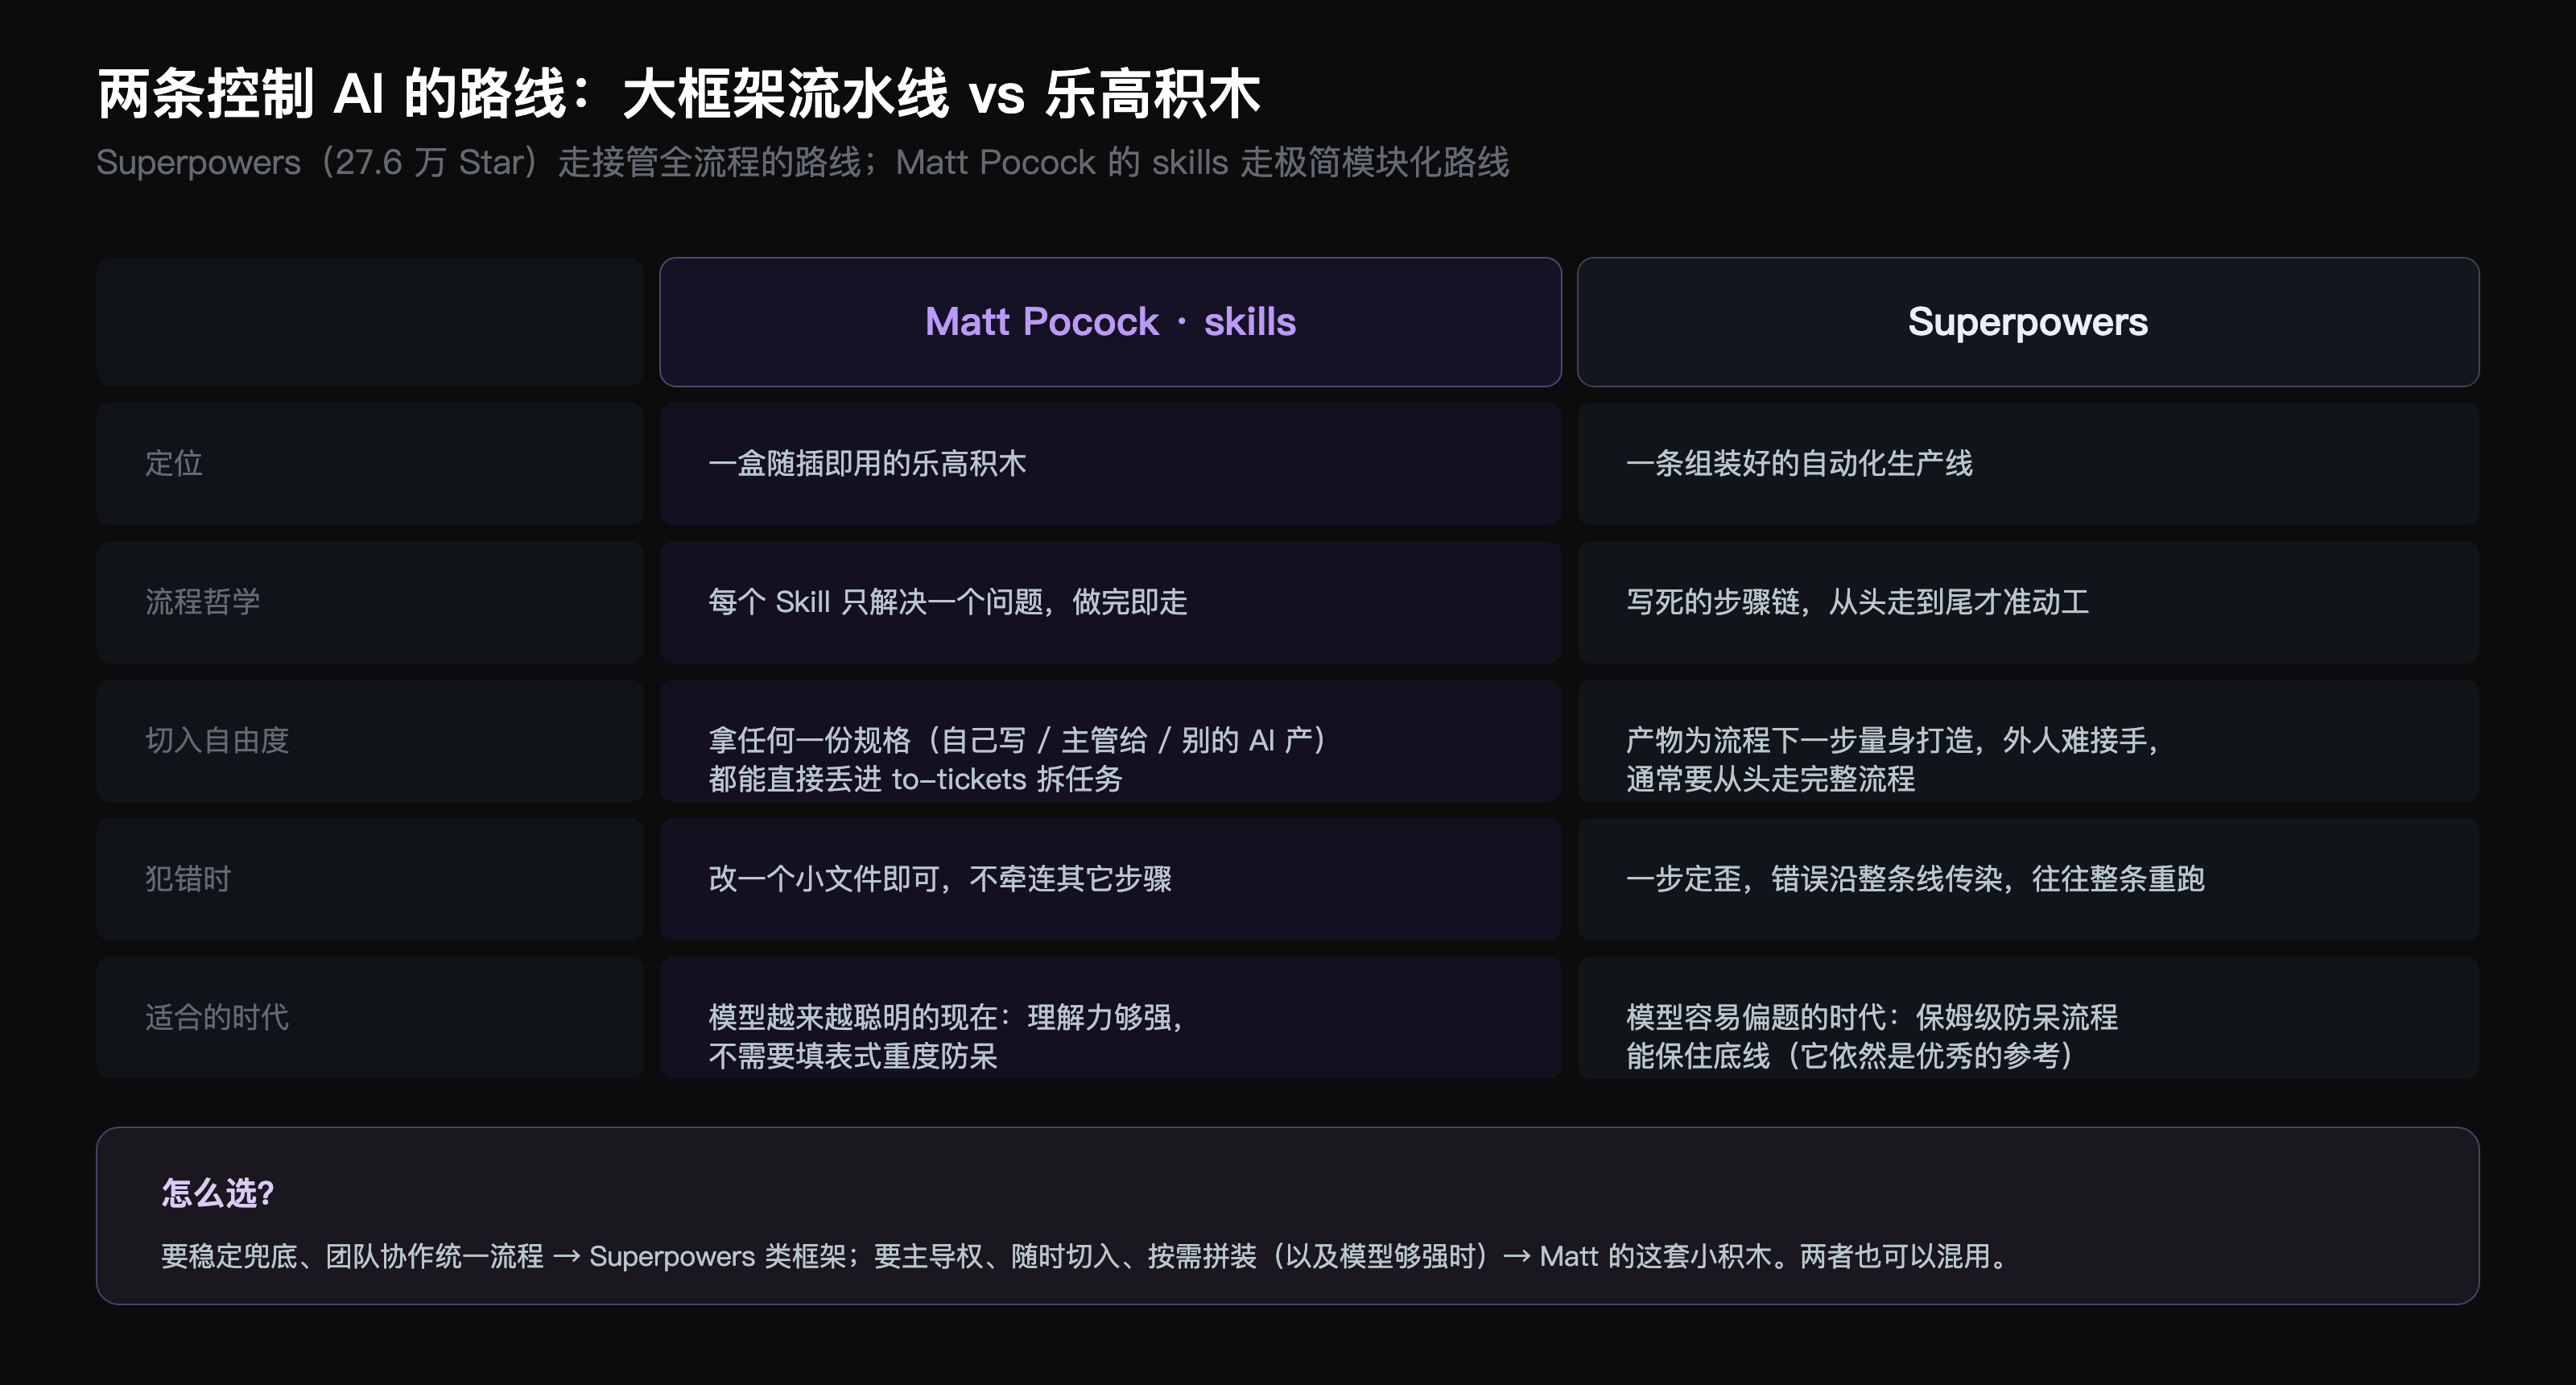
Superpowers 更像一台整机:计划驱动的开发流程、子代理执行、一整套较重的约定,你把流程交给它,换来的是高度自动化;代价是流程本身成了黑盒,出问题要钻进框架里修。Matt 的路线在 README 里说得很直白:GSD、BMAD、Spec-Kit 这类大框架「接管流程的同时也拿走了你的控制权」,所以他刻意反着来,每个 skill 小到能一眼读完、随时能改、自由拼装、对任何模型通用。选哪个取决于你要什么:要省心选整机,要掌控选零件。
读完整个仓库,我实际的感受是:grill-me 不会让你变聪明,它只是强迫你在写代码之前,把已经拥有的判断全部摆上台面。多数人用 AI 写代码的痛苦,不是 AI 不够强,而是自己的想法太模糊,模糊到只能靠 AI 瞎猜。这套工作流把「想清楚」从靠自觉变成了有流程:拷问逼你回答每个分支,规格不许你含糊,切片逼你面对依赖,测试逼你定义行为。执行速度从来不是瓶颈,你对自己需求的理解程度才是。