OpenAI 把 Codex 的「发动机」开源了:聊天框不是企业 AI 的终点
昨天 OpenAI 干了件比发新模型影响更深远的事:把驱动 Codex 的底层核心框架 Harness 全面开源,Apache-2.0 协议,可商用可修改。我把官方博客、各家报道和不久前 DeepSeek 的 Harness 文档都翻了一遍,又和朋友聊了一个下午。这篇文章,就是把那次对话里最有价值的部分整理出来。
先说结论:这次开源的不只是一段代码,而是一种「AI 应该怎么嵌入软件」的范式变化。下面分七件事讲透。
一、Harness 是什么,和你熟悉的 Codex 什么关系
很多人以为 AI Agent = 好模型 + 好 Prompt。大错特错。一个真正能在业务里跑起来的智能体,背后是一整套执行系统:理解任务、在长对话里维持记忆、压缩上下文、熟练调用工具、流式汇报进度、处理崩溃和失败、在关键时刻停下来请求人类审批,最后返回有用的结果。这个包揽所有脏活累活的「智能体循环」,就是 Harness。
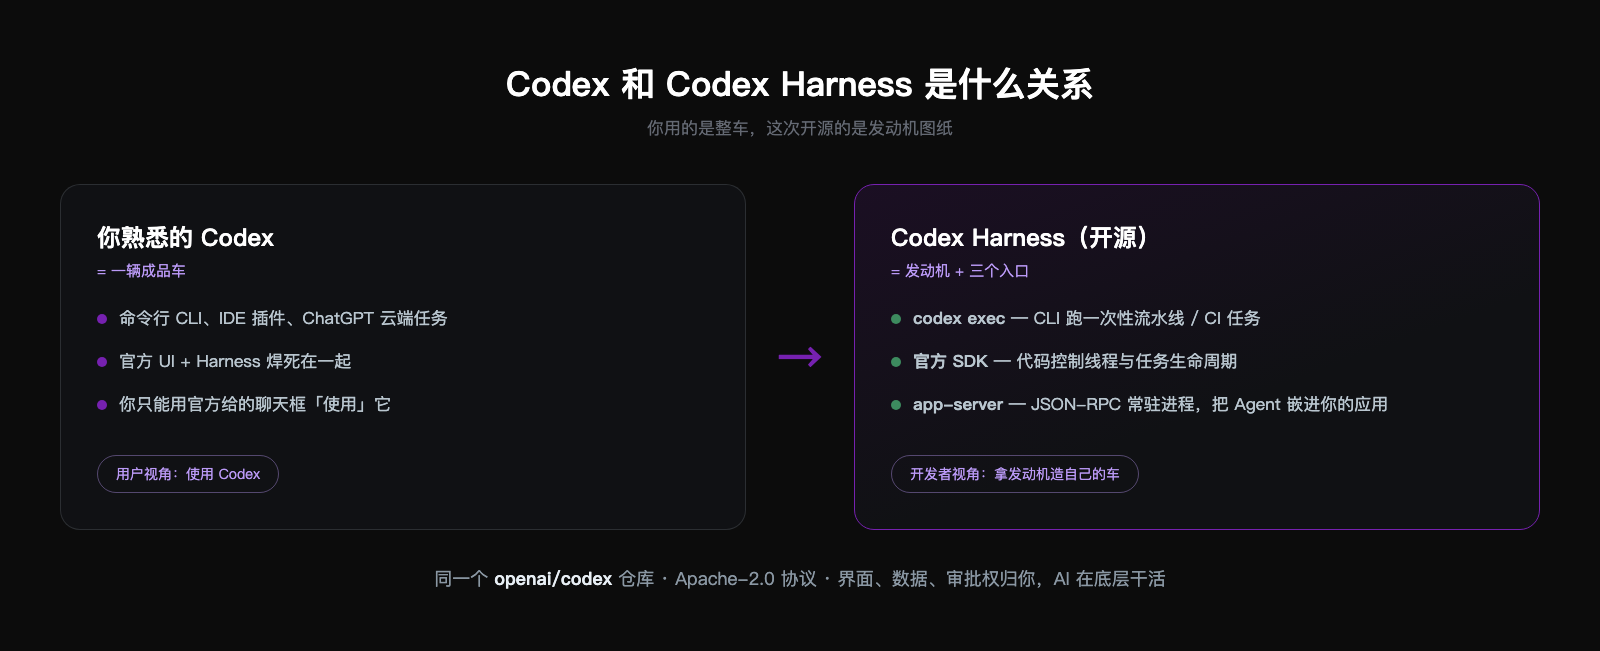
它和我们天天用的 Codex 是什么关系?一句话:Codex 是整车,Harness 是发动机。命令行 CLI、IDE 插件、ChatGPT 里的云端任务,本质都是「Harness + 一套官方 UI」的成品,以前两者焊死在一起,你只能通过官方给的聊天框「使用 Codex」。
这次开源后,Harness 被拆成三个可以单独用的入口,全在 openai/codex 仓库里。codex exec 用命令行跑一次性的有边界任务,适合 CI 和后台流水线;官方 SDK(TypeScript/Python)让你用代码启动、恢复、流式控制 Codex 线程;最核心的是 app-server,一个常驻进程,通过 JSON-RPC 协议把你的应用连到本地 Codex,支持持久会话、事件流、中途打断、把你的工具暴露给 Agent、处理人类审批。
所以区别的核心是:以前你「使用 Codex」,现在你可以把 Codex 的 Agent 能力「镶嵌进你自己的产品」——界面、数据、审批权全在你手里,AI 只在底层干活。Greg Brockman 那句「Codex 能驱动的远不止编程工具」,就是这个意思。
二、数据炸弹:怎么管理模型,比模型本身更决定表现
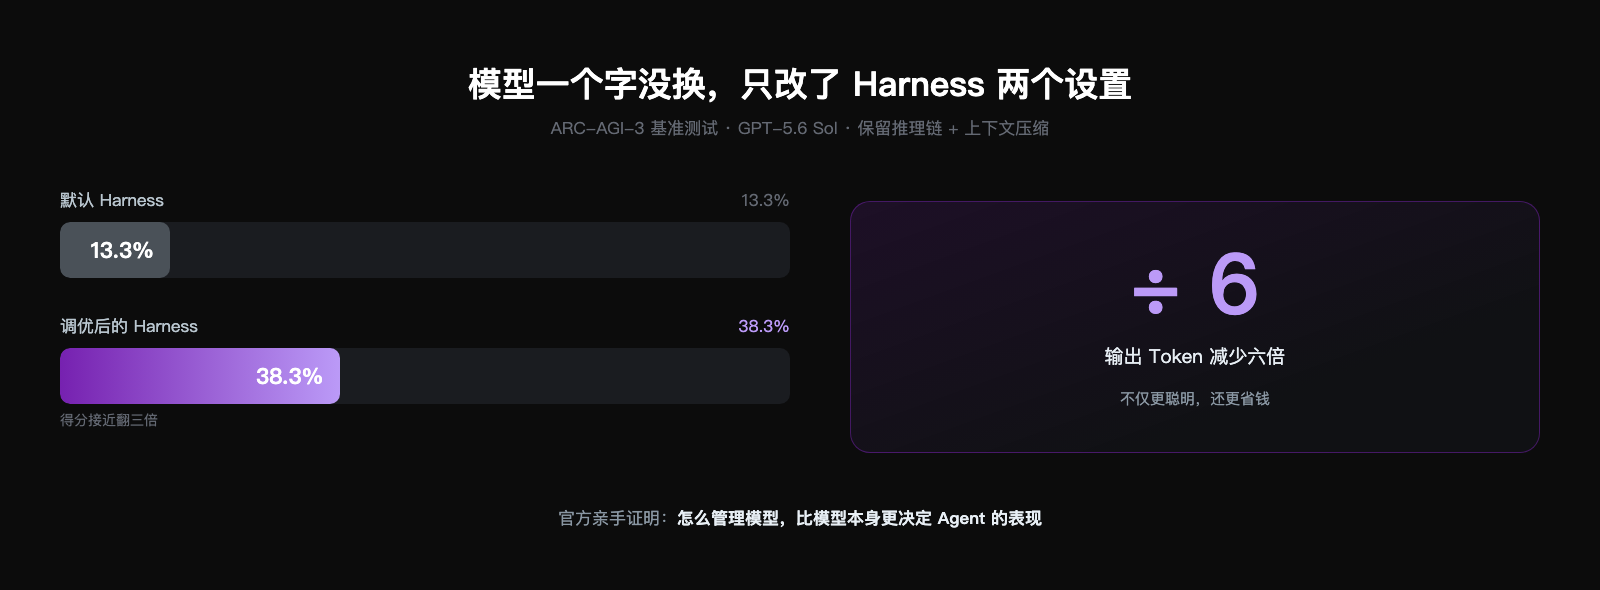
这次最炸裂的不是「开源」本身,而是 OpenAI 甩出的一组数据:在难度极高的 ARC-AGI-3 基准测试上,模型一个字没换,只调整了 Harness 的两个设计——保留推理链、上下文压缩——GPT-5.6 Sol 的得分从 13.3% 飙到 38.3%,输出 token 还减少了六倍。
这等于官方亲手盖章了一个行业秘密:「怎么管理模型」和「模型本身」一样重要,甚至更重要。过去一年大家都在卷模型、卷 prompt,OpenAI 说其实 Harness 工程才是那个隐藏的乘数——同一个模型,换个管理方式,聪明三倍还更省钱。以后再看各家 Agent 产品的横评,先问一句「你们用的 harness 一样吗」,可能比问「你们用的什么模型」更接近真相。
三、和 DeepSeek Harness 撞名:两条完全不同的路
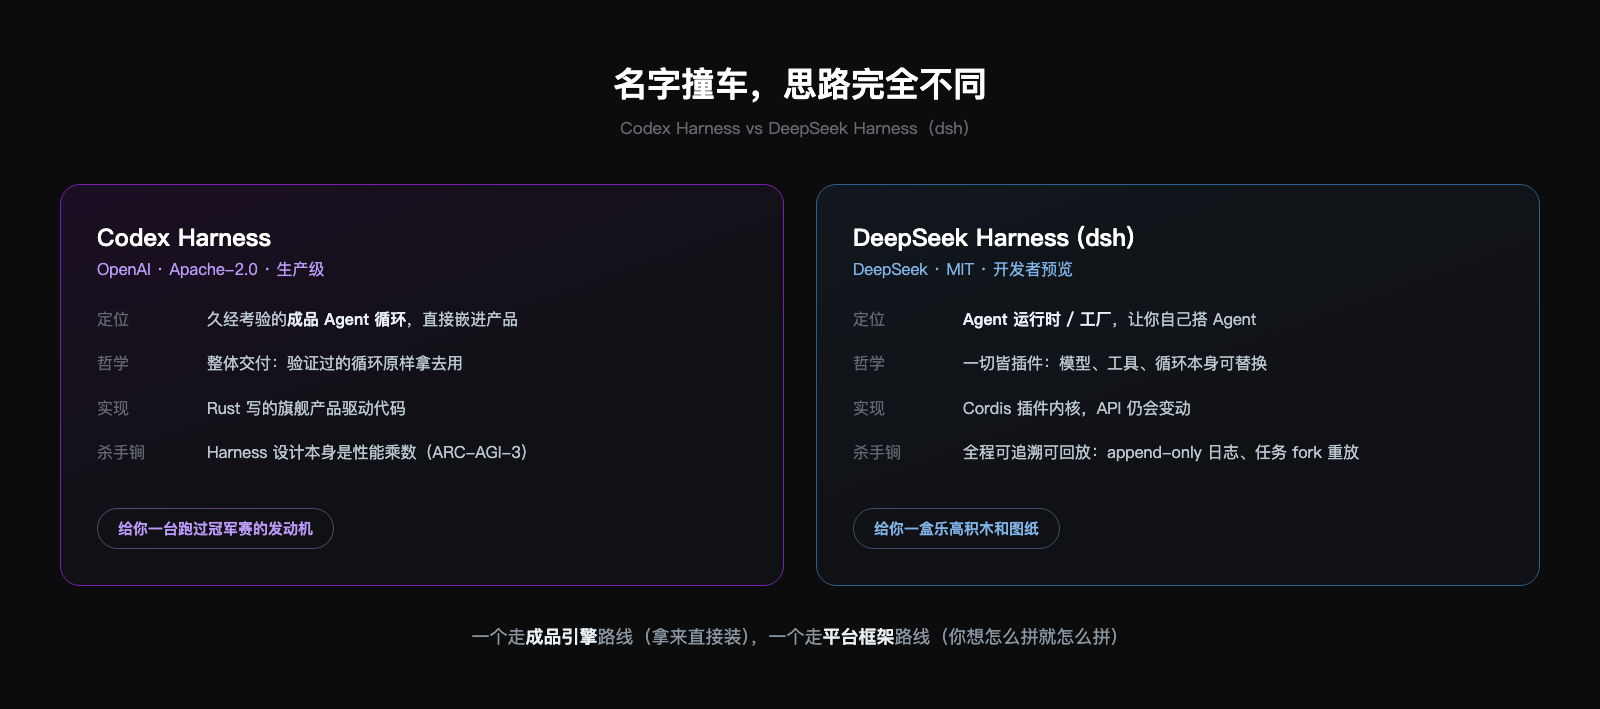
前阵子 DeepSeek 也出了个 Harness(dsh),名字撞车,思路完全不同。DeepSeek 的哲学是「一切皆插件」:模型层、工具、会话、沙箱,甚至 Agent 循环本身都可替换,基于 Cordis 插件内核。它给你的是一盒乐高积木和图纸,强调「你想怎么拼就怎么拼」,杀手锏是全程可追溯可回放——append-only 日志记录每一步推理和工具调用,任务可以 fork、可以重放。它是开发者预览版(MIT 协议),API 还会变。
OpenAI 给你的则是一台已经在赛道上跑过冠军的发动机:驱动过旗舰产品的生产级代码(Rust 写的),久经考验,拿来直接装。一个走平台框架路线,一个走成品引擎路线。没有对错,取决于你想要「自己造 Agent」,还是「省掉造 Agent 循环的全部工程量」。
四、真正的颠覆:反聊天框,和那个「拒绝之后」的循环
我认为最颠覆的点,是 OpenAI 的「反聊天框」宣言。官方博客说得很直白:与其逼每个团队把业务流程塞进通用聊天框,不如把 Agent 带进围绕实际工作设计的软件里。安全分析师看的是预警队列,客服工程师看的是账户历史,产品经理看的是需求看板——界面本身就是最重要的上下文。聊天框的问题不是体验差,而是它和企业的工作组织方式天然对不上:企业以业务流程为单位,聊天框以对话为单位。
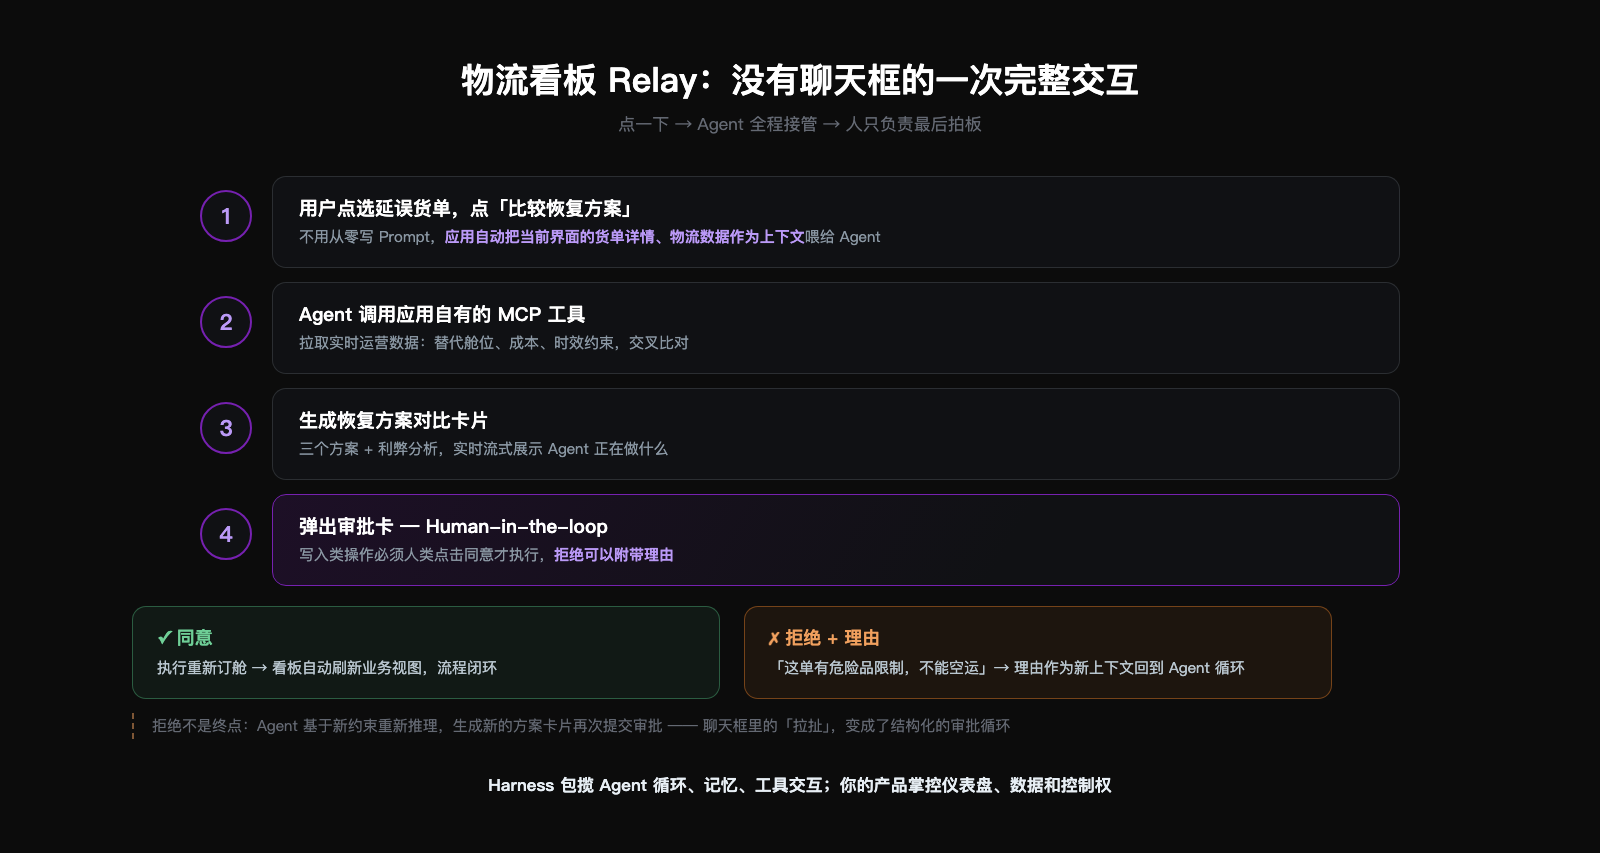
官方演示是一个叫 Relay 的物流运营看板,里面没有一个聊天框。走一遍完整交互你就懂了:用户点选一个延误货单,点「比较恢复方案」——不用从零写 Prompt,应用自动把当前界面的货单详情、物流数据作为上下文喂给 Agent;Agent 调用应用自有的 MCP 工具,拉取实时运营数据,交叉比对替代舱位、成本、时效约束;然后生成一张恢复方案对比卡片,实时流式展示它正在干嘛;最后,任何写入类操作弹出审批卡,只有人点「同意」才执行。
那拒绝之后会怎样?这是这套设计里最有意思的一环。拒绝不是终点——你的拒绝本身,连同附带的理由(比如「这单有危险品限制,不能空运」),会作为新的上下文喂回 Agent 循环。Agent 不会傻住,它基于新约束重新推理:「那空运不行,改海运加急末端配送?」然后生成一张新的方案卡片,再次提交审批。这个循环可以来回几轮,直到你满意。也可以由应用设计者预设分支:拒绝就弹固定菜单,改海运、拆单、取消,点哪个走哪个。实际产品通常两者混用:常规路径给按钮,特殊情况留个备注框让 Agent 自由发挥。
所以你看,聊天框里的「拉扯」,变成了结构化的审批循环。空白输入框被换成了按钮、勾选、对比卡片,但选项不一定是预先写死的——Agent 可以现场生成新选项。传统程序里,「拒绝之后」的每个分支都得提前写成 if-else,你想到的才有;而嵌了 Harness 的应用里,没预料到的情况可以交回给 Agent 现场推理,你只需要守住一条线:所有危险操作必须过审批卡。确定性兜底交给审批门,灵活性交给 Agent。
五、和你自己写的脚本、Skill 比,差在哪
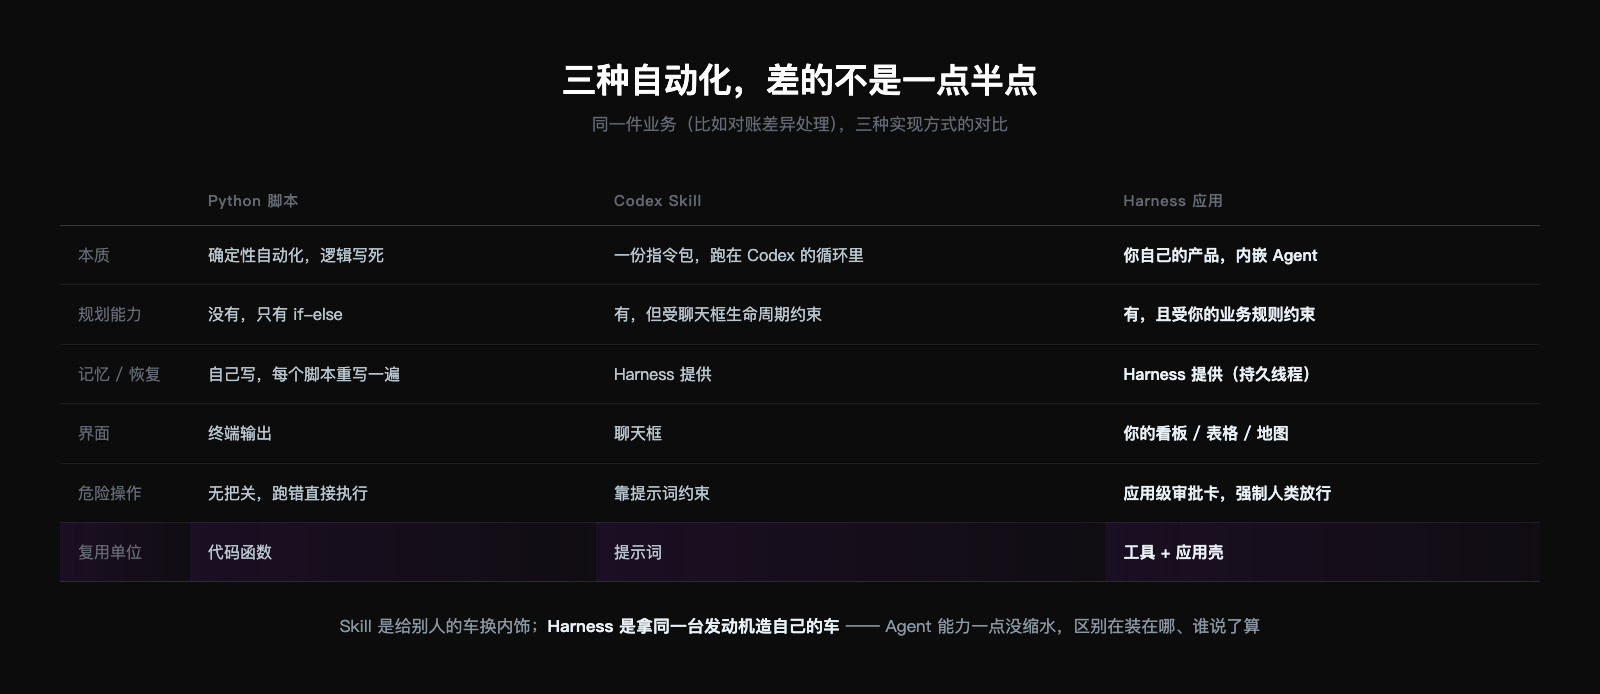
拿大家最熟悉的两样东西对比。Python 脚本是确定性自动化:逻辑是你写死的,AI 顶多被你当成一次性的 API 调用。它不会自己规划、不会从失败里恢复、不记得上下文、不会流式汇报、更没有审批机制——这些脏活你每要一个就得自己写一遍。Codex 里的 Skill 更进一步,但它本质是一份指令包,跑在别人的 Harness(Codex 的循环)里,你还是被绑在那个聊天产品的界面和生命周期上。
而 Harness 给你的是整套久经考验的 Agent 循环本身:任务规划、长对话记忆、上下文压缩、工具编排、错误恢复、断点续跑、事件流、人类审批——这些恰恰是「一个能跑的 Agent」和「一个 demo」之间 90% 的工程量,现在免费拿了。分工变成:业务规则、界面、数据归你,Agent 循环归 OpenAI。
有个比喻很准:写一个 Skill 是「给别人的车换内饰」,用 Harness 是「拿同一台发动机造自己的车」——Agent 能力一点没缩水,区别纯粹在装在哪、谁说了算。以前复用的单位是提示词,现在复用的单位是「工具 + 应用壳」。
六、没有聊天框的应用里,AI 到底在干嘛
聊到这里,朋友问了我一个最值钱的问题:既然不要聊天框了,那 AI 在这样的应用里到底起了什么价值?我的回答是:AI 的价值不是把某一步操作做得更快,而是把一整段「认知劳动」从人身上卸下来。具体是四件事。
第一,压缩决策的「输入阶段」。还是物流看板的例子:货单延误了,传统流程里处理人要打开运输系统查状态、翻客户合同看 SLA、查航班系统看替代舱位、问仓储提货时效——四五个系统来回跳,四十分钟过去,才开始「思考怎么办」。嵌了 Agent 的看板里,你点一下那个货单,Agent 已经把这些全查完、交叉比对完,把三个恢复方案连同利弊放在你面前。人最贵的时间从来不是「做决定」那一秒,而是决定之前那段信息搜集。AI 把这段砍掉了。
第二,接住「非标」的长尾。企业软件只能处理写死的流程,但真实业务里大概两成是例外情况——系统里没这个分支,以前要么报错、要么层层上报找能拍板的人。Agent 的价值恰恰在这:例外发生时,它至少能推理出「发生了什么、有哪些选项、各自什么风险」,把「完全处理不了」变成「有方案、等审批」。标准化的八成归传统代码,长尾的两成归 AI,这是分工。
第三,充当系统之间的「临时胶水」。企业里几个老系统互不联通,做个正式集成项目要几个月。而 Agent 通过 MCP 这类机制,可以直接调各家的接口——相当于每次任务现场临时集成一次。这不是替代正式集成,而是让很多原本「不值得立项」的自动化变得可能。
第四,也是最关键的角色定位:AI 有全部的提案权,没有最终的决定权。那张审批卡就是这套分工的制度化表达——AI 负责读、查、分析、起草方案,人负责判断和担责。企业最怕的从来不是效率低,是出了错说不清谁负责;「AI 提案、人类签字」这个结构恰好把责任链保住了。
那为什么还必须留着看板,不能全交给 AI?因为 AI 的价值要兑现,需要两个条件:可见和可控。聊天框的问题是它俩都没有——你不知道它在后台干嘛,也没法在关键处拦住它。看板把「发生了什么、进行到哪一步、要不要放行」全摆在你眼前,AI 在里面就像一个坐在你旁边的副驾驶:仪表盘还是你的,操作杆你可以随时接管,但巡航、查表、拟方案这些活它全包了。一句话:聊天框时代,AI 是「问答机器」;看板时代,AI 是「数字员工」——它不抢方向盘,但它把驾驶舱里所有不需要人的活都接了过去。
七、怎么造这样一个应用?用 AI 造
最后一个问题:以前做 Agent,是跟 AI 聊天、把工作流跑通、沉淀成一个可复用的 Skill。现在这已经是一款应用了,不是 Skill 了,怎么让 AI 把它做出来?答案有点套娃:你依然是用 AI 来做这个应用,只不过这次让 AI 写的不是 Skill,而是一个「嵌着 Agent 的应用外壳」。
先看解剖结构。这样一个看板应用就三块:UI 壳(看板、列表、按钮、审批弹窗,就是个普通 Web 应用,没有任何 AI 成分);你的业务工具(查数据、执行动作的接口,以 MCP 服务的形式暴露给 Agent——本质是把你原来的脚本和工作流包装成工具);一根连接线(你的应用通过 Codex SDK 或 app-server 协议跟底下的 Codex Agent 对话)。你会发现,Agent 本身一行都不用你写,OpenAI 给现成的。
四步配方。第一步,先在聊天里把流程跑通——和你做 Skill 的第一步完全一样,让 Agent 在对话里完整走一遍业务工作流,证明它干得了这活。第二步,把能力从对话里抽出来,写成 MCP 工具,这是关键转变:Skill 时代的产物是一段提示词,现在的产物是几个实实在在的工具函数;做完这步,你的业务知识就从「聊天记录」变成了「任何 Agent 可调用的接口」。第三步,让 AI 帮你造 UI 壳,给它三样东西:app-server 的官方协议文档、官方 SDK 代码、你的需求描述(哪个按钮触发 Agent、哪些操作必须弹审批卡),然后就是熟悉的「跑起来 → 看效果 → 让它改」循环。第四步,把判断力写进系统提示词:审批门槛设在哪、拒绝后怎么重试、哪些动作永远不许自动执行——这是 Skill 思路的延续,只是换个地方存。
所以对着老路子看,变化就一条:以前的终点是「一个可以在 Codex 里复用的 Skill」,现在的终点是「一个自己就是产品的应用,Skill 的知识拆成了 MCP 工具加规则指令,住在你自己的程序里」。
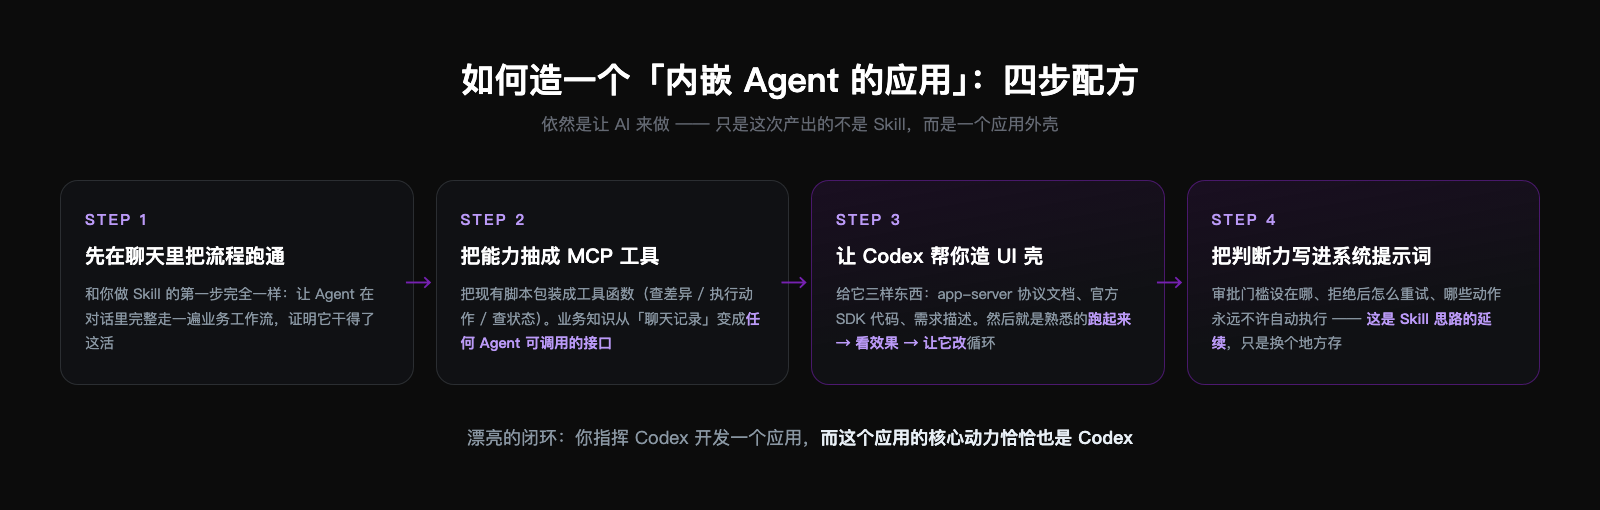
这件事最妙的地方,是一个漂亮的闭环:你指挥 Codex 帮你开发一个应用,而这个应用的核心动力恰恰也是 Codex。以前是「AI 帮你写工具」,现在是「AI 帮你写一个里面有 AI 的产品」。
过去一年大家都在卷聊天机器人,产品越来越像,护城河越来越浅。Codex Harness 的开源指了一条别的路:别再逼用户把业务流程塞进聊天框了。通用聊天框不会杀死专业界面,它会让每个专业界面长出一颗聪明的大脑。